Comment nous avons optimisé le modèle Qwen 3.6 pour notre agent Junie

Il y a quelque temps, nous avons lancé un projet à long terme visant à permettre aux utilisateurs d’exécuter Junie entièrement sur leur machine, avec une inférence locale, sur une grande variété de configurations matérielles. Nous avons récemment publié une (très attendue) version initiale de Junie Local qui fonctionne sur MacBook M5 avec Qwen3.6-27B.
Dans cet article, je vais vous parler des efforts que nous avons déployés pour que cela fonctionne, et vous expliquer pourquoi nous avons choisi Qwen3.6-27B plutôt que Qwen3.8-27B. Nous avons apporté des optimisations sur l’ensemble de la pile, de l’agent Junie lui-même au moteur d’inférence que nous avons choisi.
Commençons par Junie : après tout, c’est là que vous commencerez à interagir avec le modèle local.
Optimisations de Junie
Extension du contexte évolutif de l’agent
Comme tout autre agent de programmation, Junie dispose d’une boucle d’exécution principale, dans laquelle s’effectue tout son travail :
- Tout d’abord, l’utilisateur spécifie une tâche.
- Ensuite, Junie l’envoie au LLM.
- Ensuite, le LLM répond avec des appels à des outils (comme des commandes Bash, des instructions pour lire/écrire des fichiers, etc.).
- Enfin, Junie renvoie le résultat de cette commande.
Voici un schéma très simplifié de ce qui se passe en coulisses :
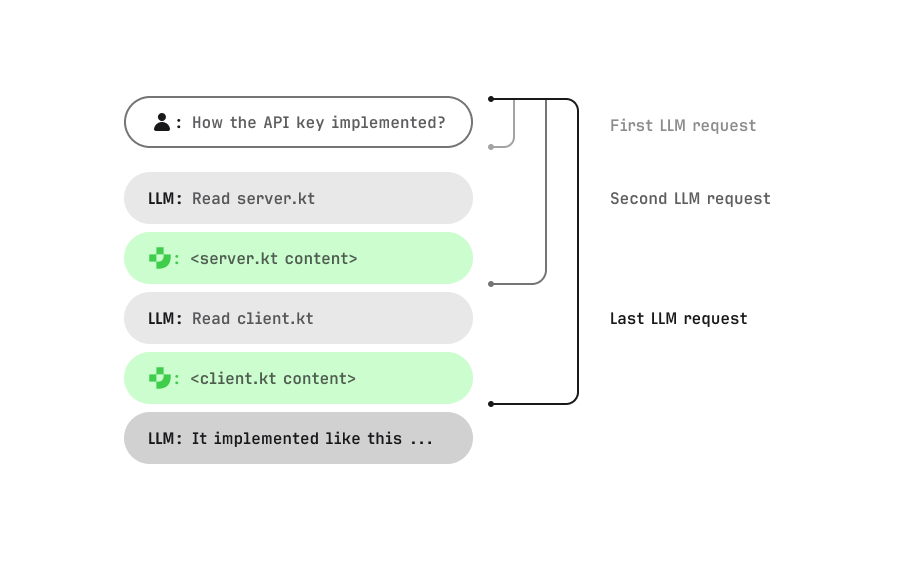
Comme vous pouvez le voir sur le schéma, le LLM continue de recevoir des requêtes qui enrichissent progressivement le contexte, ce qui lui permet de réutiliser en partie les informations qu’il a déjà traitées. Plus précisément, cela signifie que nous pouvons réutiliser les données de prefill de la requête précédente pour la suivante. Ces données sont appelées KV-cache.
Mais si nous demandons à Junie d’effectuer une deuxième tâche dans la même session, il ne récupère que les éléments de contexte pertinents et les place dans la fenêtre :
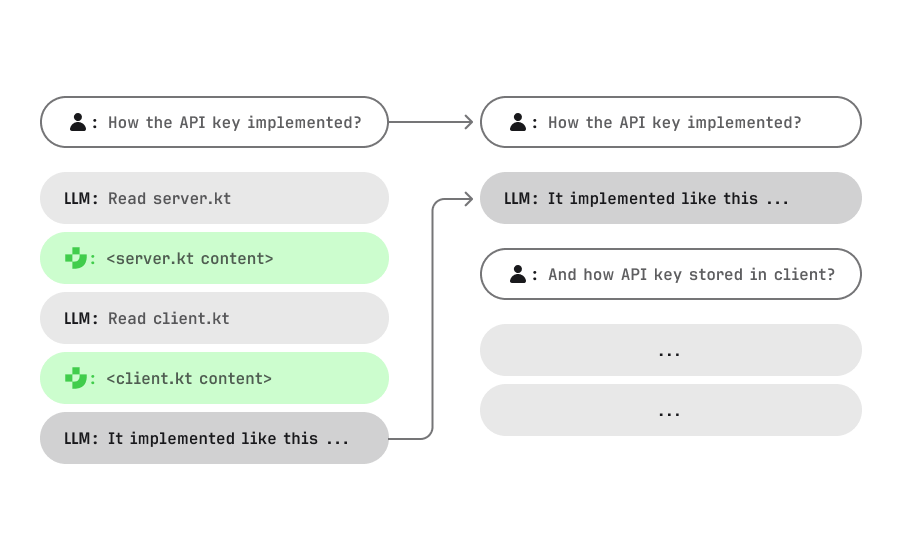
Avec des modèles cloud, cela fonctionne généralement à la perfection, car même si le modèle a de nouveau besoin du contenu de certains fichiers, il demandera à y accéder et les traitera à nouveau. Le prefill est également très rapide.
Pour les modèles locaux, ce n’est pas le cas : le prefill n’est pas aussi rapide, et il faut en fait beaucoup de temps pour « lire » les fichiers.
Pour résoudre ce problème, nous avons modifié la logique de l’inférence locale. Maintenant, nous ajoutons chaque nouvelle requête directement au contexte en cours :
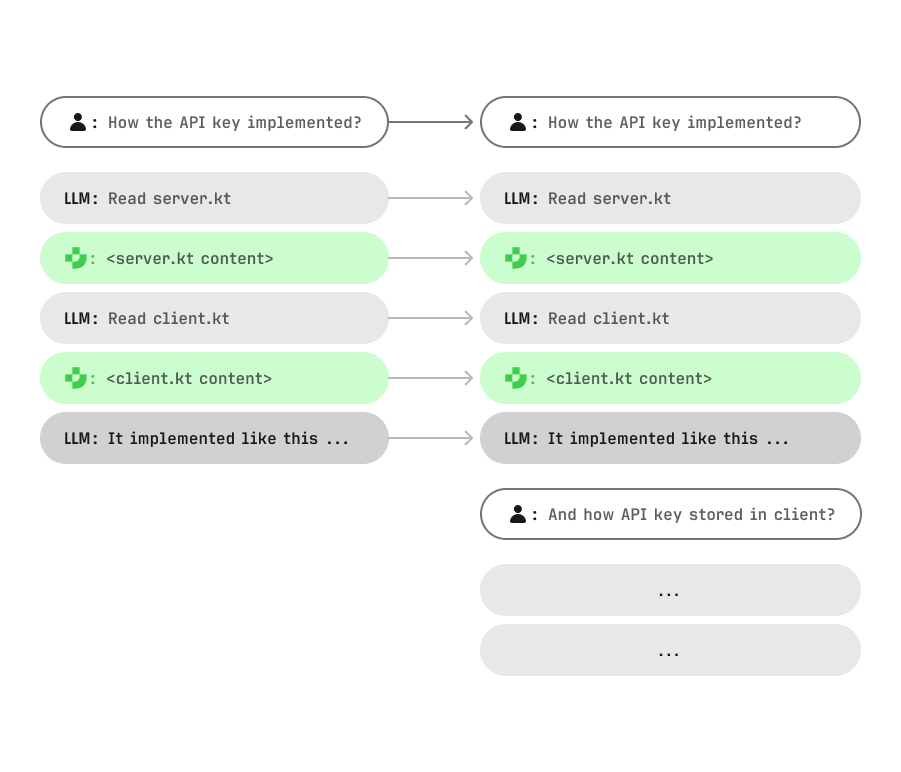
Nous pouvons ainsi réutiliser les caches KV de la tâche précédente. C’est-à-dire que si le modèle a déjà lu un fichier, ce dernier restera dans la fenêtre de contexte, et nous n’aurons pas besoin de le « relire ».
Maximiser le préfixe réutilisable initial
Nous avons effectué une optimisation similaire concernant le prompt système et le contexte initial, que Junie envoie lorsqu’il démarre une nouvelle session de programmation.
Dans la section précédente, le fonctionnement était quelque peu simplifié : lors de la première requête envoyée au LLM, beaucoup plus de données lui sont en réalité transmises que ce qui était indiqué sur le schéma :
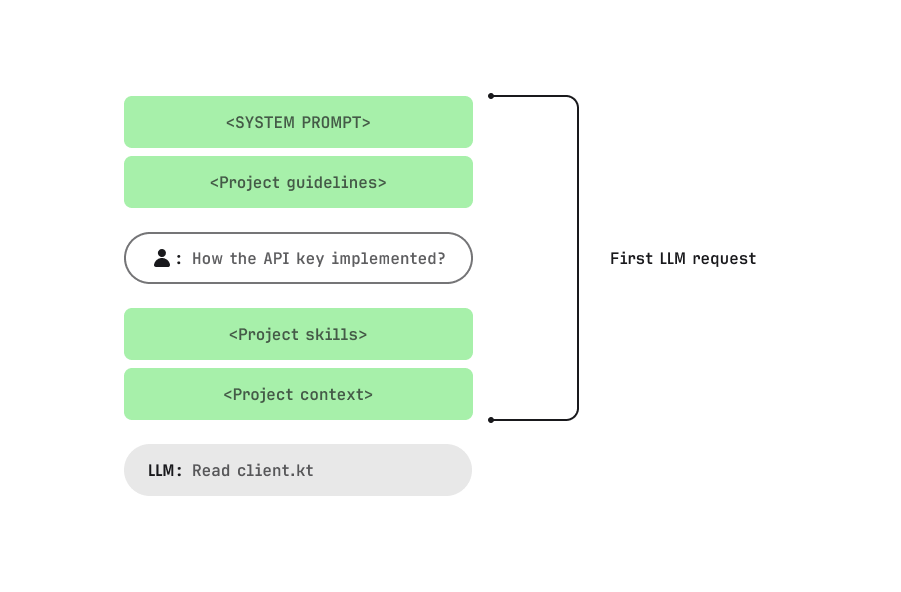
Comme vous pouvez le voir, un tout autre ensemble d’informations est envoyé au LLM. Et toutes ces informations sont envoyées et traitées au début de chaque nouvelle session. Naturellement, nous préférerions pouvoir les mettre en cache d’une manière ou d’une autre 🙂
Pour cette raison, nous avons modifié l’ordre dans lequel nous envoyons ces données :
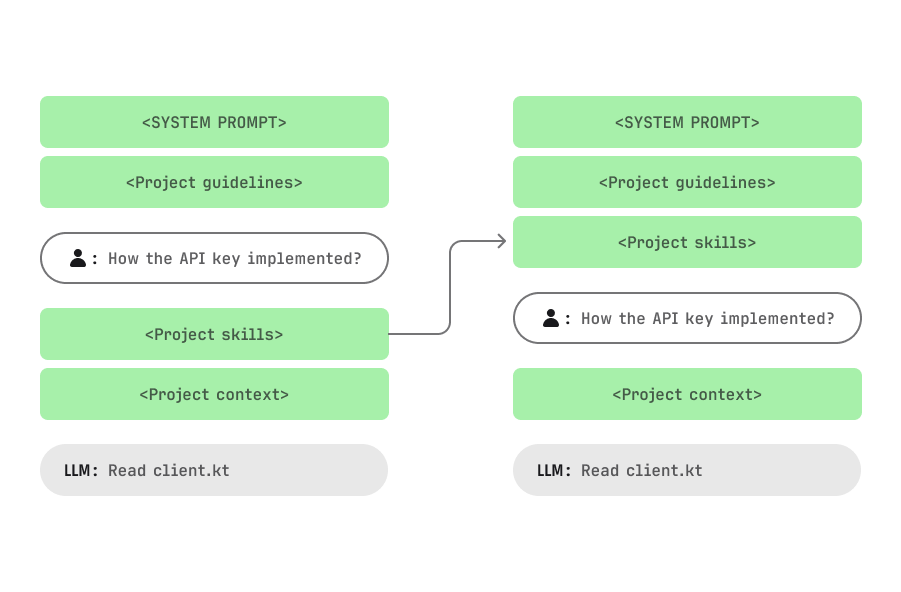
Nous avons également ajouté une logique spécifique au moteur d’inférence pour mettre en cache le préfixe jusqu’à la requête de l’utilisateur. Ainsi, pour les tâches suivantes (dans le même projet), celui-ci est simplement réutilisé. Nous avons exclu le contexte du projet qui suit la requête de l’utilisateur, car il est relativement limité et se compose principalement des fichiers de premier niveau du projet, qui peuvent donc changer fréquemment.
Faire fonctionner les mises à jour de progression
Avec des modèles cloud plus puissants, Junie demande au LLM d’ajouter un bloc spécial dans un format de type XML contenant des mises à jour à l’intention de l’utilisateur. Malheureusement, Qwen 3.6 ignore pour l’essentiel ce type de demande. Cependant, le modèle décrit ses actions en texte brut dans le résultat d’une requête au LLM : le LLM envoie certains appels d’outils accompagnés d’un texte explicatif.
Le correctif est donc simple : il suffit d’utiliser ce texte généré par Qwen 3.6 comme mise à jour destinée à l’utilisateur. Ces adaptations sont spécifiques au modèle, c’est-à-dire que nous avons eu de la chance que Qwen 3.6 se comporte ainsi. Certains modèles n’affichent aucune information, tandis que d’autres génèrent beaucoup trop de texte.
Suppression des appels inutiles au LLM
Cette autre optimisation, qui consiste à désactiver toutes les requêtes facultatives au LLM, peut sembler anodine, mais elle a véritablement contribué à rendre l’agent plus efficace. Concrètement, cela impliquait de désactiver toute logique qui générait une courte description de la tâche. Même si cela s’est fait au prix d’une légère dégradation de l’expérience utilisateur, nous avons considéré que le compromis restait acceptable. Nous avons également complètement désactivé le mode multiagents, car sur un M5, les requêtes du LLM sont traitées plus efficacement de manière séquentielle. Il est donc inutile d’exécuter plusieurs agents en parallèle : les performances seraient de toute façon limitées par le moteur d’inférence.
Optimisations des paramètres du modèle
reasoning_effort: None
Lors de nos tests de la version cloud de Qwen3.6-27B en interne, nous avons constaté que l’activation du raisonnement n’apportait pas d’amélioration significative de la qualité. Ainsi, pour la version locale, nous avons décidé de désactiver complètement le raisonnement. C’est un point important, car du point de vue du moteur d’inférence, les tokens utilisés pour le raisonnement sont les mêmes que ceux utilisés pour générer la réponse principale. Ainsi, lorsque le raisonnement est désactivé, nous devons générer 2 à 3 fois moins de tokens, ce qui se traduit par une exécution des tâches deux fois plus rapide, pour un impact négligeable sur la qualité.
Quantification
Nous avons choisi d’utiliser la version 4 bits, car ses performances sont à peine inférieures à celles de la version 8 bits sur les benchmarks. De plus, la génération étant limitée par la mémoire, la version 4 bits est environ deux fois plus rapide que la version 8 bits. Toutefois, lorsque nous avons comparé la vitesse de prefill entre les versions 8 bits et 4 bits, nous avons constaté qu’elles étaient identiques… Nous avons trouvé cela étrange, alors nous avons creusé plus loin.
Optimisation du moteur d’inférence
Hack de prefill
Certains pourraient se demander pourquoi nous nous soucions du prefill. Après tout, tout l’internet regorge de benchmarks sur la vitesse de génération et d’options d’optimisation.
À vrai dire, sur une carte graphique dédiée (comme la RTX 5090), ils pourraient avoir raison de remettre en question son importance. Sur ce type de matériel, c’est effectivement extrêmement rapide, car le prefill est limité par le calcul, et les GPU discrets sont généralement très puissants. Cela signifie que vous pouvez atteindre une vitesse de prefill d’environ 3 700 tokens par seconde avec les configurations par défaut. Sur un M5, sans configuration particulière, on atteignait environ 650 tokens par seconde. Ainsi, lorsque le modèle demandait le contenu du fichier, c’est-à-dire lorsqu’il était en phase d’analyse, la majeure partie du temps était consacrée au prefill, et non à la génération !
Le pire, c’est qu’il n’y avait aucune différence, en termes de vitesse de prefill, entre la quantification 4 bits, 8 bits ou 16 bits. Mais pourquoi ? Le prefill est essentiellement limité par la puissance de calcul, ce qui signifie que nous ne sommes pas du tout limités par la vitesse de la mémoire. Et il s’avère que la majorité des opérations matricielles pendant le prefill sont effectuées en mode 16 bits complet. C’est-à-dire que tous les poids sur 4 bits ont été convertis en nombres sur 16 bits avant que les opérations ne soient effectuées. Mais le processeur M5 dispose d’opérations spéciales pour les nombres sur 8 bits, qui sont nettement plus rapides que les opérations sur 16 bits. Ainsi, lorsque nous avons appliqué un correctif au paquet MLX-VLM qui a basculé certaines* opérations matricielles pendant le prefill vers le 8 bits, nous avons obtenu un gain de vitesse de prefill d’environ 40 % !
D’ailleurs, c’est la principale raison pour laquelle nous avons décidé de nous concentrer sur les puces M5. Les puces M4 n’incluent pas ces instructions d’arithmétique 8 bits, et l’arithmétique 16 bits du M4 rend le prefill 20 à 30 % plus lent.
*Qwen3.6-27B utilise à la fois des couches à attention complète et des couches de self-attention. Nous avons constaté qu’en dépit d’une quantification sur 4 bits, les poids de l’attention complète restent stockés avec une précision en 16 bits. Comme ces couches restent de toute façon à une précision totale, nous ne leur avons pas appliqué cette optimisation ; elle ne s’applique qu’aux couches de self-attention, où elle réduit effectivement l’utilisation de la mémoire et la charge de calcul. Voici le lien vers le correctif dans MLX-VLM. Cette même optimisation peut aussi être appliquée dans vLLM, simplement en modifiant le fichier de configuration du modèle. Exemple de configuration
Décodage spéculatif via MTP et correspondance par n‑grammes
Nous avons appliqué les optimisations standards ci-dessous :
- La MTP (prédiction multitokens) avec un modèle de brouillon distinct : une approche de décodage spéculatif dans laquelle un modèle de brouillon plus petit propose plusieurs tokens à l’avance, que le modèle principal vérifie ensuite.
- Décodage spéculatif par N-grammes : au lieu d’utiliser un modèle de brouillon, cette méthode recherche dans le contexte des séquences de tokens déjà apparues et « prédit » les tokens suivants en les comparant à ces séquences.
Nous avons activé les deux méthodes simultanément. Concrètement, cela signifie que, lors de la génération, nous acceptons parfois non seulement les ~3 tokens proposés par la MTP, mais aussi jusqu’à 8 tokens supplémentaires acceptés via la méthode des n-grammes. L’illustration ci-dessous montre des tokens générés à l’état brut, colorés selon la méthode ayant produit chaque jeton accepté (modèle de brouillon ou n-gramme).
En combinant ces approches, on obtient une accélération de la génération pouvant atteindre 2×.
Qwen3.8-27B
Compte tenu de tout cela, pourquoi n’avons-nous pas utilisé la version 3.8 au lieu de 3.6 ?
Malheureusement, Qwen 3.8 nécessite l’activation du mode de raisonnement pour fonctionner correctement. Sans cela, la qualité de la sortie se dégrade nettement : sur des tâches typiques, le modèle peut même échouer complètement, en se retrouvant bloqué dans une boucle où il répète indéfiniment le même appel d’outil. Mais l’activation du mode de raisonnement augmente considérablement le nombre de tokens générés : environ 5 fois plus de tokens sont produits avec un effort de raisonnement moyen. Comme le temps de prefill reste à peu près constant, le ralentissement net est plus proche de 4 fois que de 5 fois. Cela reste un coût significatif. C’est pourquoi, pour l’instant, sur le matériel Mac, Qwen3.6-27B reste le meilleur choix.
Dernières réflexions
J’espère qu’après avoir pris connaissance de notre parcours, vous comprenez que se concentrer uniquement sur la vitesse de génération en tokens par seconde n’est pas la bonne approche pour les tâches courantes des agents de programmation.
Vous devez optimiser toutes les parties de la pile, notamment :
- La génération et le prefill : le processus de décodage token par token et la phase initiale de traitement du contexte.
- Les paramètres du modèle et la quantification : la précision des poids du modèle et sa configuration.
- L’infrastructure de l’agent : la couche d’orchestration environnante (appels d’outils, flux de contrôle, logique de prompt) qui fait fonctionner le modèle.
C’est ce que nous prévoyons de faire à l’avenir. La prise en charge des M5 n’est que la première étape. Nous avons déjà des prototypes pour DGX Spark et RTX 5090 (et nous envisageons même des cartes 24 Go), donc restez à l’écoute !