Junie エージェント向けに Qwen 3.6 モデルを最適化した経緯

当社はユーザーがさまざまなハードウェア構成で Junie をローカル環境で完全動作させ、ローカル推論を可能にするための長期プロジェクトを少し前に立ち上げました。そしてついに Qwen3.6-27B を搭載した MacBook M5 で動作する Junie Local の初期バージョンを最近リリースしました。
このブログでは、これを実現するのに必要だったことに加えて、Qwen3.8-27B ではなく Qwen3.6-27B でリリースすることにした理由をお伝えします。当社は Junie エージェント本体から採用する推論エンジンに至るスタック全体にわたって最適化を行いました。
まずは Junie からご説明しましょう。何と言っても、ローカルモデルとのやり取りはここからが始まるからです。
Junie の最適化
エージェントのローリングコンテキストの拡張
他のあらゆるコーディングエージェントと同様に、Junie にはすべての処理が行われるメインの実行ループがあります。
- まず、ユーザーがタスクを指定します。
- 次に、Junie がそのタスクを LLM に送信します。
- 次に、LLM がいくつかのツールの呼び出し(Bash コマンドやファイルの読み書き命令など)を使用して応答します。
- 最後に、Junie がこのコマンドの実行結果を送り返します。
以下はこの内部動作を大幅に簡略化したフローチャートです。
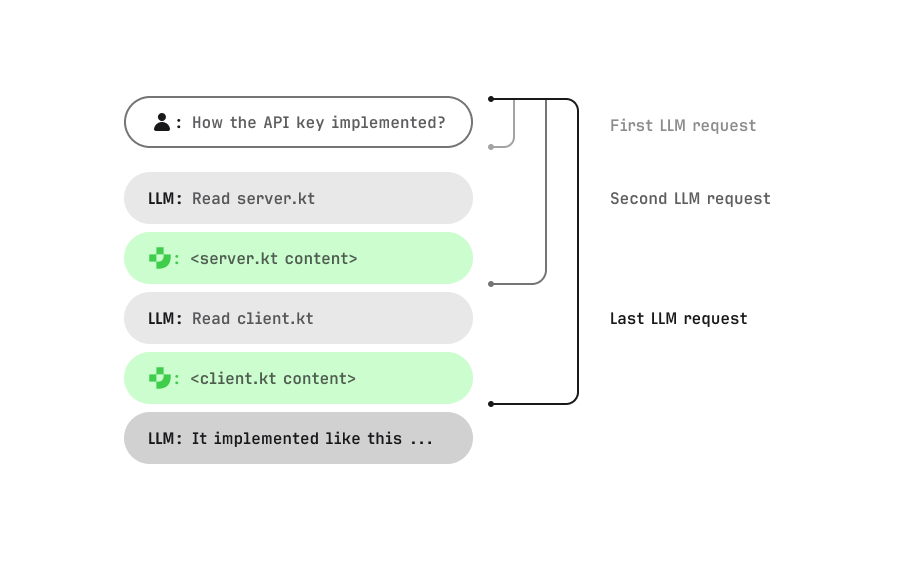
このチャートからわかるように、LLM はコンテキストを拡張するリクエストを継続的に受け付けています。これにより、すでに処理したリクエストに含まれる情報を部分的に再利用できるようになっています。具体的に言うと、前のリクエストのプリフィルデータを次のリクエストに再利用できるということです。また、このようなデータは KV キャッシュと呼ばれます。
しかし、Junie に 同じセッション内で 2 つ目のタスクを実行させた場合は、以下のようにコンテキストから関連する部分だけが取り出され、ウィンドウに格納されます。
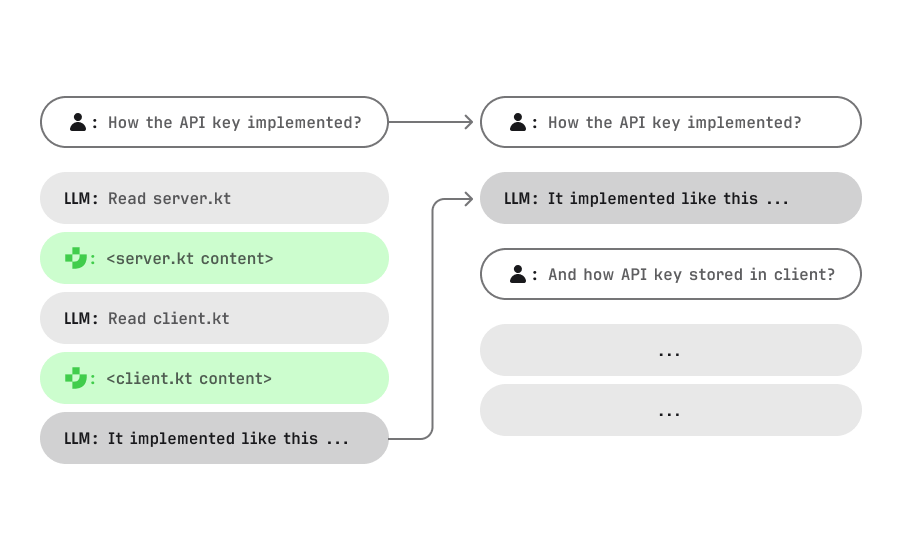
クラウドモデルの場合、通常はこれで問題なくうまくいきます。モデルが一部のファイルの内容が再び必要になったとしても、アクセスをリクエストしてその内容を再処理できるからです。プリフィルも非常に高速です。
ローカルモデルの場合はそうはいきません。プリフィルはそこまで速くなく、実際にファイルを「読み込む」のにかなりの時間を要するからです。
この問題を解決するため、ローカル推論のロジックを変更しました。その結果、新しいリクエストが以下のようにすべてローリングコンテキストに直接追加されるようになりました。
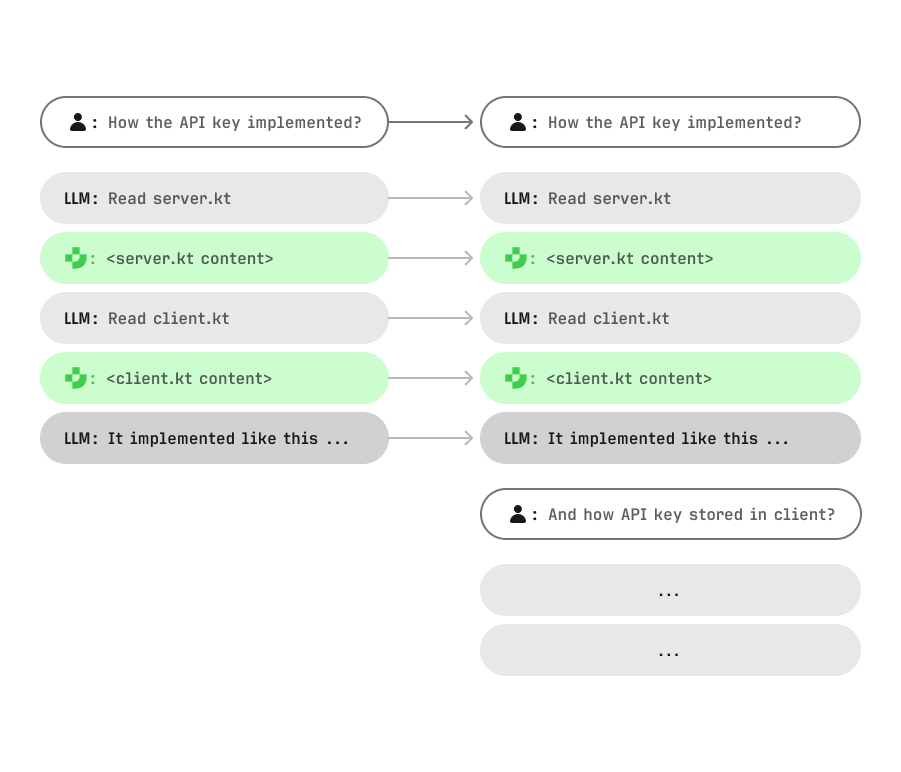
この方法なら、前のタスクで作成された KV キャッシュを再利用できます。つまり、モデルがすでにファイルを読み込んでいれば、読み込んだファイルがコンテキストウィンドウに残り、再度「読み込む」必要がなくなるのです。
最初の再利用可能なプレフィックスを最大化
他に実施した同様の最適化は、新しいコーディングセッションを開始する際に Junie が送信するシステムプロンプトと初期コンテキストに関連するものです。
前のチャートではフローが多少簡略化されていました。最初の LLM リクエストの際には、図に示されていたよりもはるかに多くのデータが実際には LLM に送信されています。
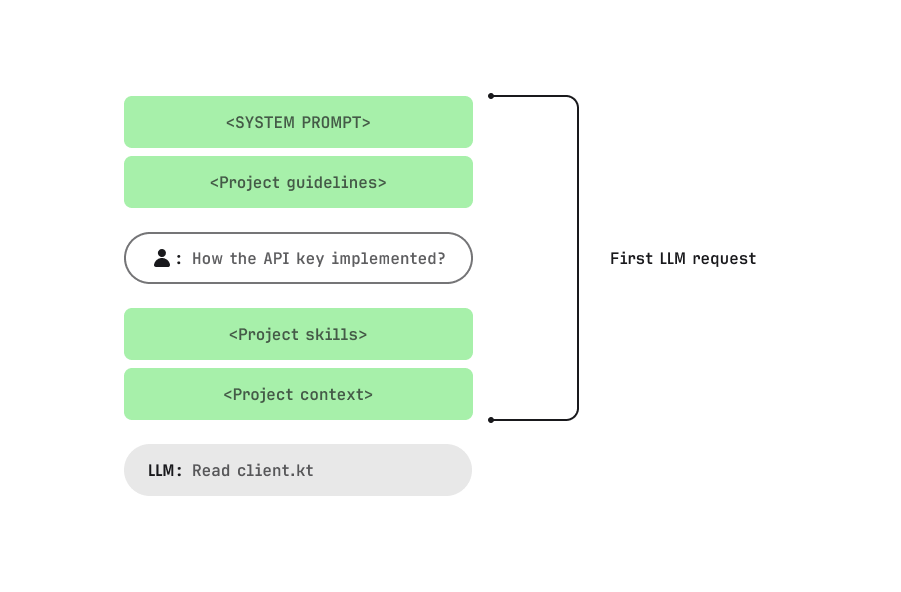
ご覧の通り、まったく異なる情報が LLM に送信されています。また、この情報はすべて新しいセッションを開始するたびに送信・処理されます。何らかの方法でこれをキャッシュしておきたいと思うのは当然のことでしょう 🙂
この点を踏まえて、このデータの送信順序を以下のように変更しました。
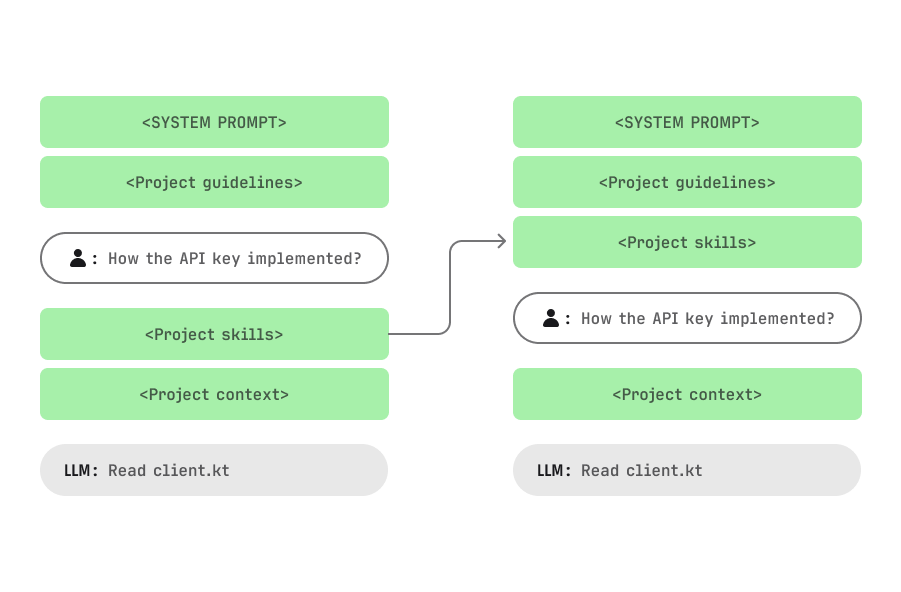
さらに、推論エンジンに特別なロジックを追加することで、ユーザーのリクエストに至るまでのプレフィックス(冒頭部分)をキャッシュするようにしました。これにより、プレフィックスをそのまま(同じプロジェクト内の)後続のタスクで再利用できるようになりました。ユーザーのリクエスト以降のプロジェクトコンテキストについては除外しました。サイズがかなり小さく、そのほとんどがトップレベルのプロジェクトファイルで構成されており、頻繁に変更される可能性があるためです。
進捗情報を機能させる
Junie は強力なクラウドモデルを使用する場合、ユーザーに表示される進捗情報を含む XML に似た形式の専用ブロックを追加するように LLM に依頼します。残念ながら、Qwen 3.6 はこのようなリクエストをほとんど無視してしまいます。それと同時に、このモデルは自身のアクションを LLM リクエストの結果の一部としてプレーンテキスト形式で記述します。つまり、LLM がツールの呼び出しとそれを説明する付随テキストを送信するのです。
そのため、解決策は簡単です。Qwen 3.6 が生成したそのテキストをユーザー向けの進捗情報として利用するのです。このような対策はモデルごとに異なります。同じ場面で何も出力しないモデルもあれば、逆に大量のテキストを生成するモデルもあるため、Qwen 3.6 がこのように動作してくれたことは幸いでした。
LLM の不要な呼び出しをやめる
次の最適化は、省略可能な LLM リクエストをすべて無効化することです。これは些細なことのように思われるかもしれませんが、エージェントの効率化に大きく貢献しました。具体的には、タスクの短い説明を生成するロジックをすべて無効化したのです。そうすることでユーザーエクスペリエンスを多少犠牲にしたのは確かですが、この程度の損失は過大ではないと判断しました。さらに、マルチエージェントモードも完全に無効化しました。M5 上で LLM リクエストを処理する最も効率的な方法は逐次処理であり、複数のエージェントを有効にしたところで推論によるボトルネックが発生してしまうため、意味がないためです。
モデルパラメーターの最適化
reasoning_effort: None
Qwen3.6-27B のクラウド版の社内テストを行っていた際、推論機能を有効にしても品質の大幅な向上にはつながらないことに気づきました。そこで、ローカル版では推論機能を完全に無効化することにしました。これには大きな意味があります。推論エンジンの視点で使用される推論トークンは、メイン応答の生成に使用されるトークンと同じものだからです。そのため、推論の無効化に伴ってトークンの生成数を 2~3 分の 1 に削減し、それによってタスクの実行速度を 2 倍にし、それと同時に品質に及ぼす影響をごくわずかに抑える必要があります。
量子化
4-bit 版のベンチマークでのパフォーマンスは 8-bit 版よりもわずかに劣るだけでした。しかも 8-bit 版 は生成処理のメモリがボトルネックとなっており、4-bit 版を使用すれば 8-bit 版の約 2 倍高速になることから、4-bit 版を採用することにしました。ところがプレフィルの速度を比較したところ、8-bit 版も 4-bit 版も速度が同じであることに気がつきました。これはおかしいと思い、さらに詳しく調査することにしました。
推論エンジンの最適化
プレフィルのハック
そもそも、なぜ私たちがプレフィルを気にしているのか不思議に思う方もいらっしゃるかもしれません。何しろ、インターネット上には生成速度のベンチマークや最適化オプションが溢れかえっています。
RTX 5090 のようなディスクリート GPU の場合、その重要性を疑問視するのは一理あるかもしれません。そのようなハードウェアでは、プレフィルは計算能力に依存しており、ディスクリート GPU は通常非常に高性能であるため、確かに極めて高速です。これはデフォルトの構成で 3,700 t/s 程度のプレフィル速度を得られるということです。一方、標準状態の M5 のプレフィル速度は 650 t/s 前後でした。つまり、モデルがファイルの内容を要求していたとき(すなわち調査を行っていたとき)、時間の大部分は生成ではなくプレフィルに費やされていたということです!
さらに困ったことに、プレフィル速度は 4-bit、8-bit、16-bit 量子化の間で何の違いもありませんでした。でも、なぜでしょう? 実はプレフィルは計算能力に依存しており、メモリの速度には一切制限されません。さらに、プレフィル中のマトリックス演算の大部分は完全な 16-bit モードで実行されていたことがわかりました。つまり、演算の実行前に 4-bit の重みがすべて 16-bit の数値に変換されていたのです。しかし、M5 プロセッサには 16-bit 演算よりもはるかに高速な 8-bit 数値専用の演算が備わっています。そこで、プレフィル中に一部*のマトリックス演算を 8-bit に切り替えるパッチを MLX-VLM パッケージに適用してみたところ、プレフィル速度が最大で 40% 向上しました!
これこそが当社が M5 チップに注力しようと決めた主な理由なのです。M4 チップにはこのような 8-bit 演算命令がなく、M4 の 16-bit 演算ではプレフィル速度が 20 ~ 30% 低下してしまいます。
*Qwen3.6-27B はフルアテンションレイヤーとセルフアテンションレイヤーの両方を使用しています。4-bit 量子化であっても、フルアテンションの重みは 16-bit のフル精度のままであることが判明しました。これらのレイヤーはどのような場合であってもフル精度が保たれるため、この最適化は適用されず、実際にメモリや計算負荷を軽減できるセルフアテンションレイヤーにのみ適用されています。MLX-VLM のパッチは、こちらのリンクで提供しています。さらに、この最適化はモデルの構成ファイルを編集するだけで vLLM にも適用できます。構成例
MTP と n-gram マッチングによる投機的デコーディング
標準的な最適化として、以下を適用しました。
- 独立したドラフトモデルを用いた MTP(Multi-Token Prediction = マルチトークン予測): 小規模なドラフトモデルが数トークン先まで提案し、メインモデルがそれを検証する投機的デコーディング手法です。
- N-gram 投機的デコーディング: ドラフトモデルの代わりに、このメソッドはコンテキスト内で以前に繰り返されたトークンシーケンスを探し出し、それと照合することによって次に現れるトークンを「予測」します。
当社は両方のメソッドを同時に有効化しました。実際には生成中に MTP が提案した最大 3 個のトークンだけでなく、n-gram メソッドで承認された最大 8 個の追加トークンを受け入れることもあります。以下の画面では、受け入れた各トークンを生成したメソッドごとに生の生成トークンが色分けされています(ドラフトモデルと n-gram)。
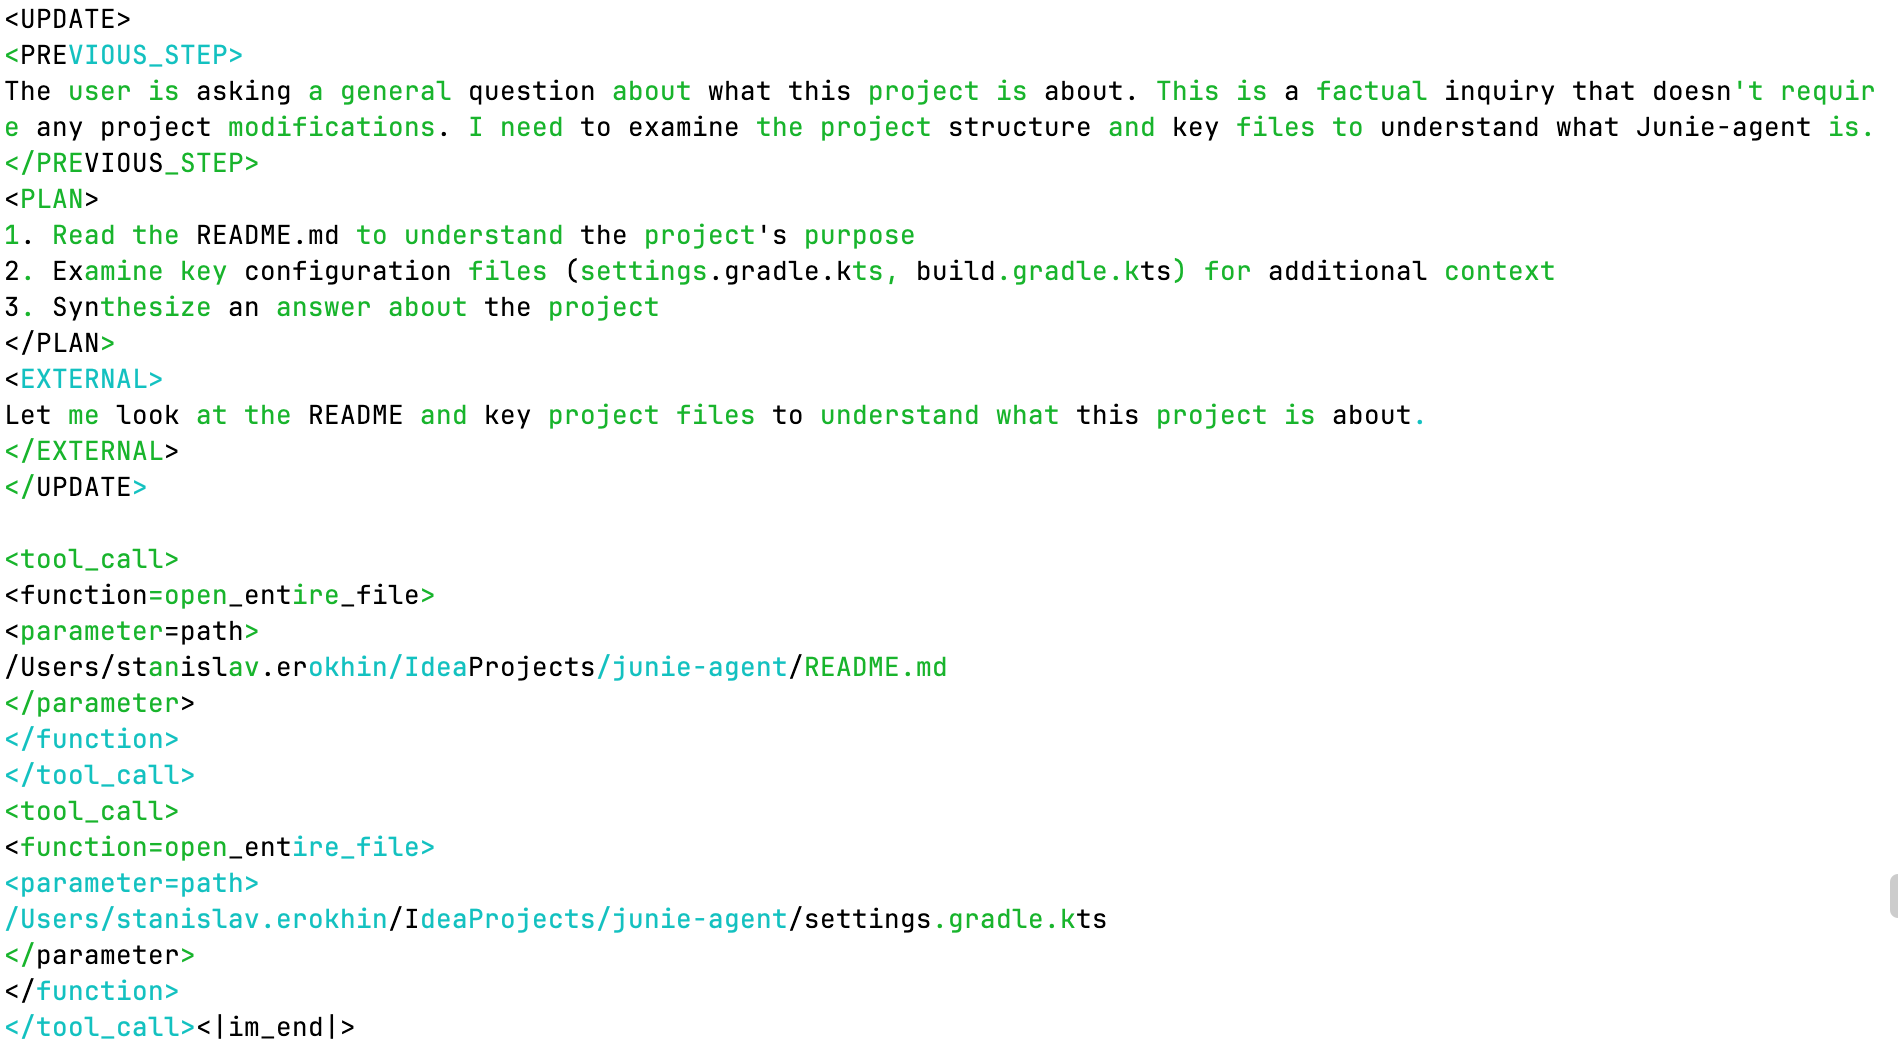
メソッドを組み合わせることで、生成速度が最大 2 倍に向上します。
Qwen3.8-27b
では、3.8 ではなく、3.6 を使用する理由は何でしょうか?
残念ながら、Qwen 3.8 を正常に機能させるには推論モードを有効化する必要があるからです。推論モードを有効化しない場合は、一般的なタスクでも出力の品質が著しく低下してしまいます。完全に失敗して同じツール呼び出しを無限に繰り返すループに陥ってしまうことさえあるのです。しかし、推論モードを有効化すると、生成されるトークン数が大幅に増加します。推論レベルを「中」に設定した場合、生成されるトークン数は約 5 倍に増加します。プレフィルの所要時間はほぼ変わらないため、実質的な処理速度の低下は 5 倍ではなく、4 倍程度ということになります。それでもなお、費用はかなりかさみます。そのため、現時点では Mac ハードウェア上では Qwen3.6-27b の方が依然として優れた選択肢となっているのです。
まとめ
当社の取り組みをお読みになり、一般的なエージェントプログラミングタスクに関しては、生成の t/s (秒単位のトランザクション数) だけに焦点を当てるのは誤った見方であることがお分かりいただけたかと思います。
以下を含む、スタックのすべての部分を最適化する必要があります。
- 生成とプレフィル: トークン単位のデコード処理と最初のコンテキスト処理パス。
- モデルパラメーターと量子化: モデルの重みの精度と構成。
- エージェントハーネス: モデルを駆動する周辺のオーケストレーションレイヤー(ツール呼び出し、制御フロー、プロンプトロジック)。
まさにこれこそが、当社が今後取り組もうとしていることです。M5 のサポートはあくまで第一歩に過ぎません。すでに DGX Spark や RTX 5090 向けのプロトタイプも用意していますので(24GB カードについても検討中)、今後もご期待ください!
オリジナル(英語)ブログ投稿記事の作者: