让本地 AI 更智能、更快速

我们希望本地编码智能体既聪明又快速:能够理解代码库、完成有价值的工作,并且不必长时间等待。这次 Junie Local 更新让你可以切实地在自己的机器上使用能力更强的模型。
在首个版本中,我们不得不在同一模型的两个版本之间做出选择。关闭推理时,Qwen3.6 的速度足以在笔记本电脑上使用。Qwen3.8 能完成更多任务,但只有启用推理才能可靠工作,因此完成任务所需时间大约长四倍。我们选择了速度。
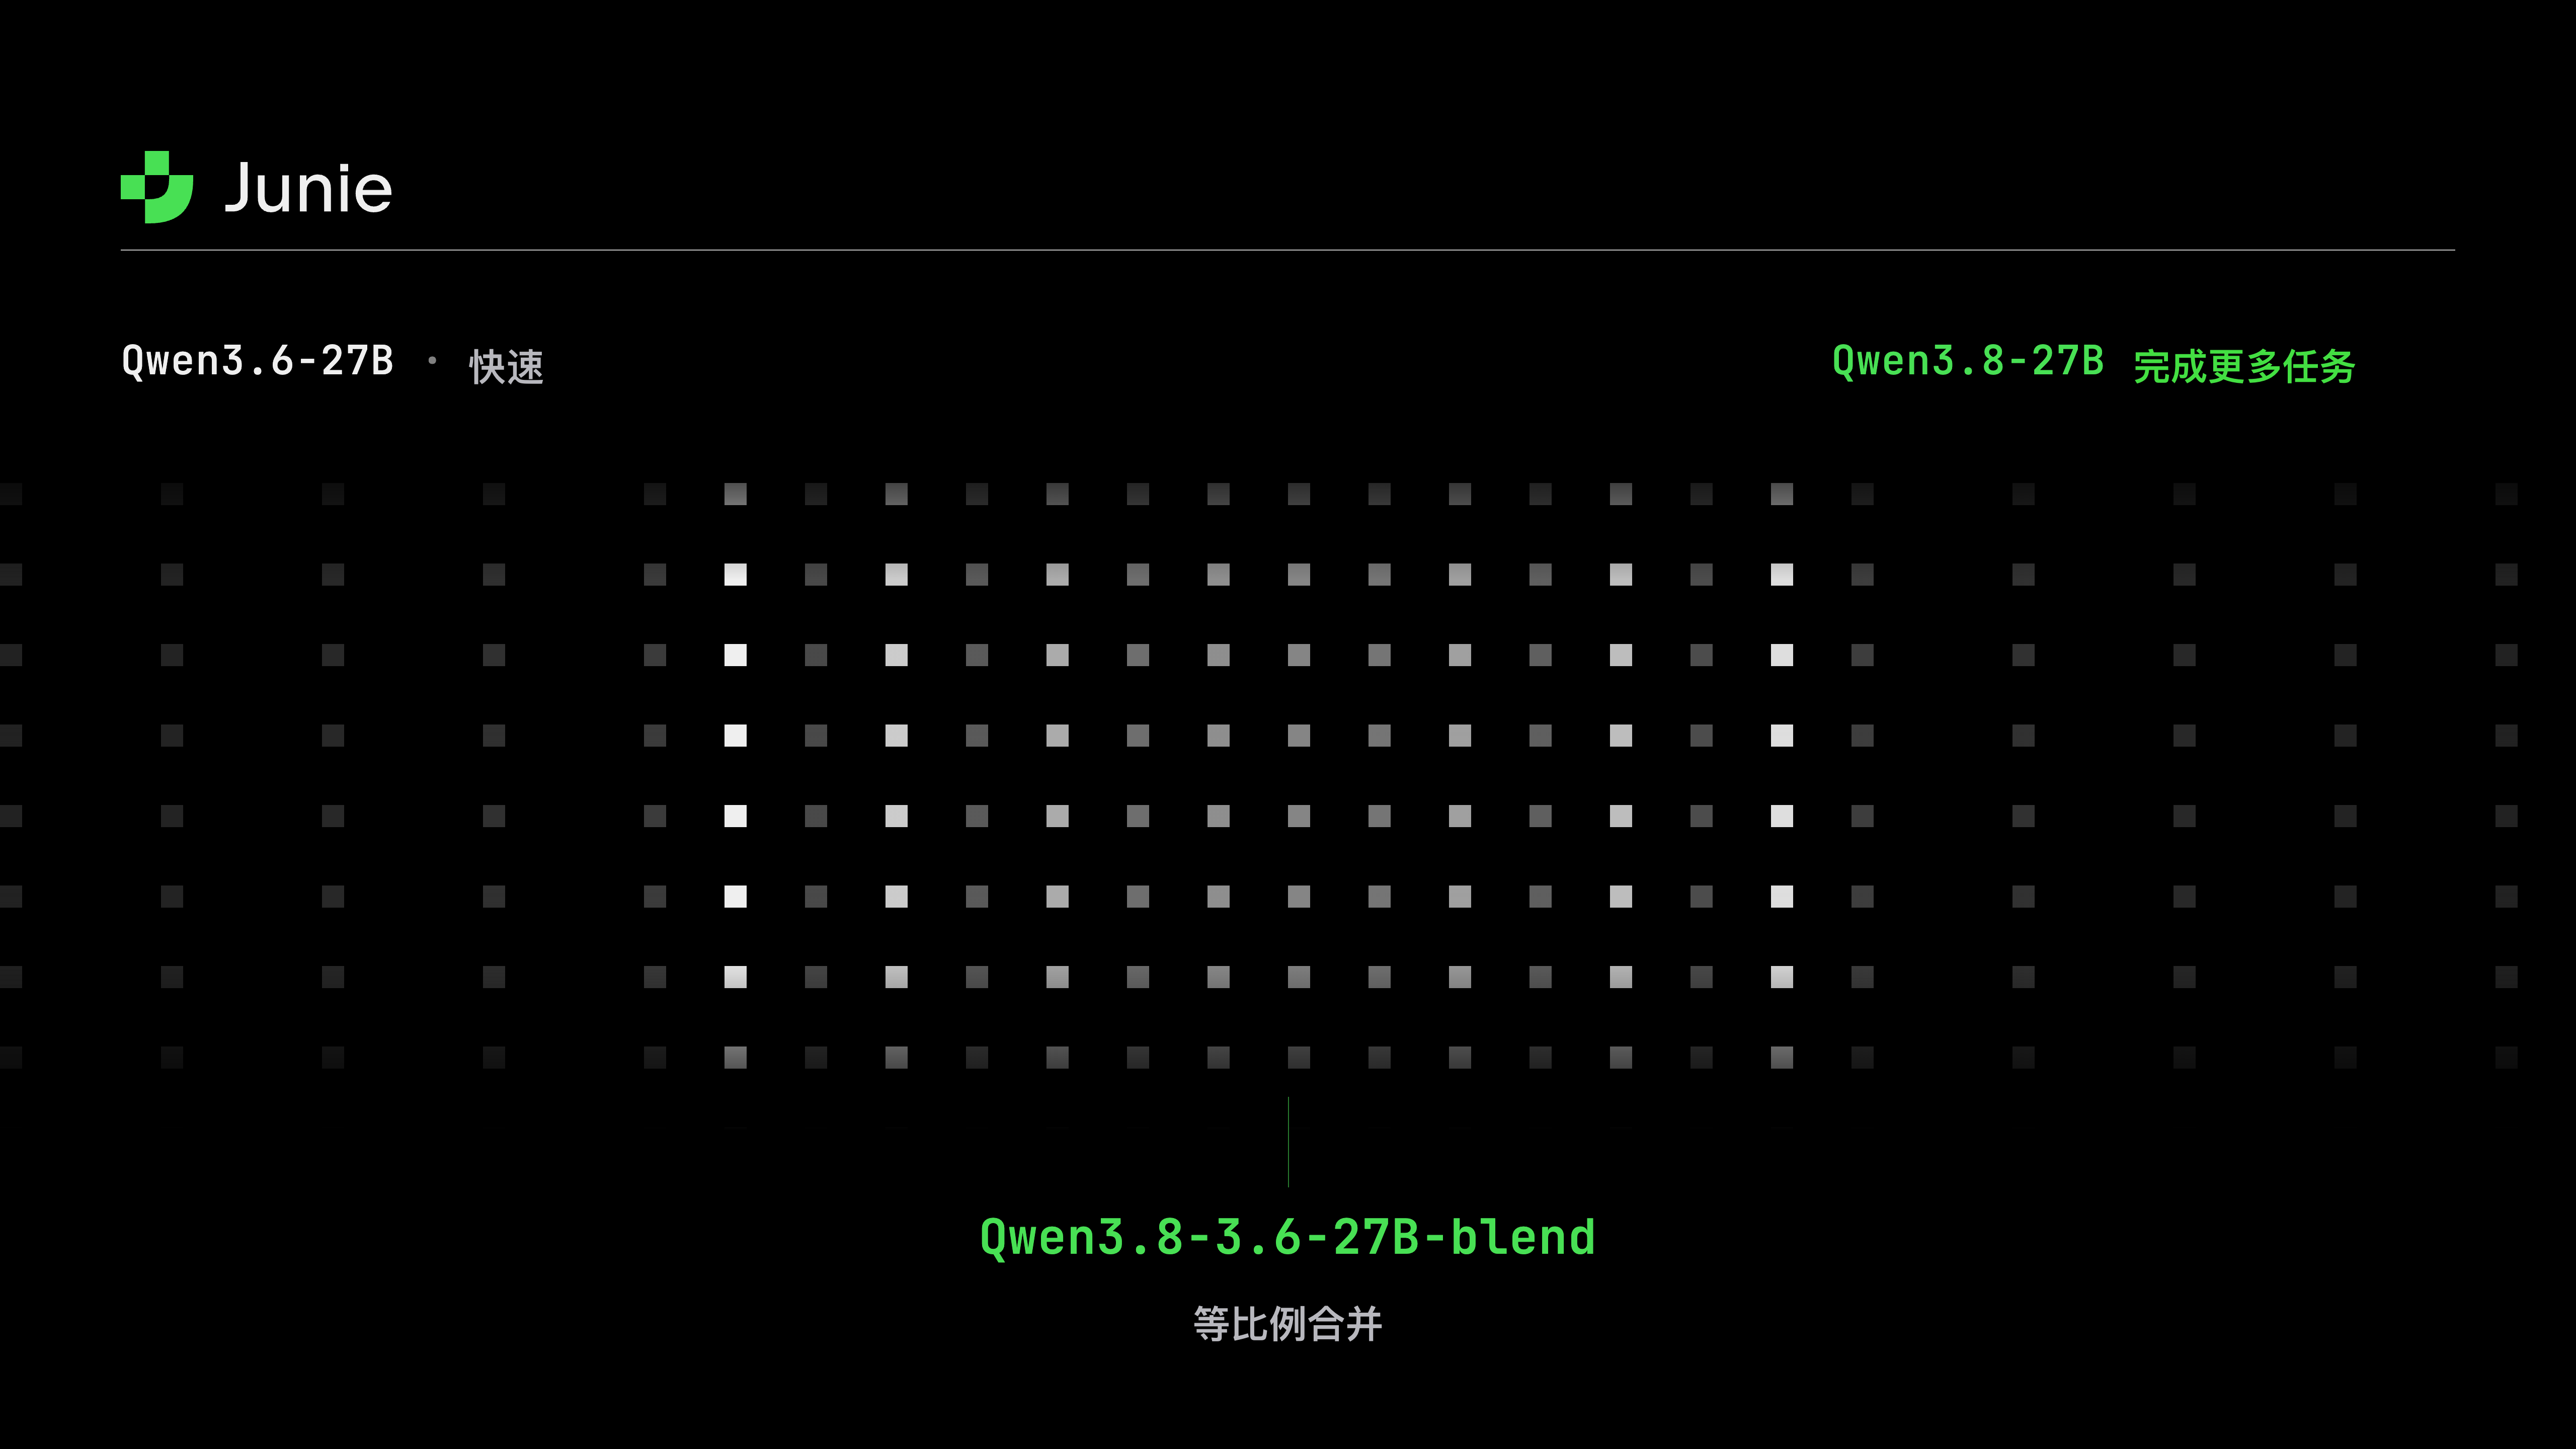
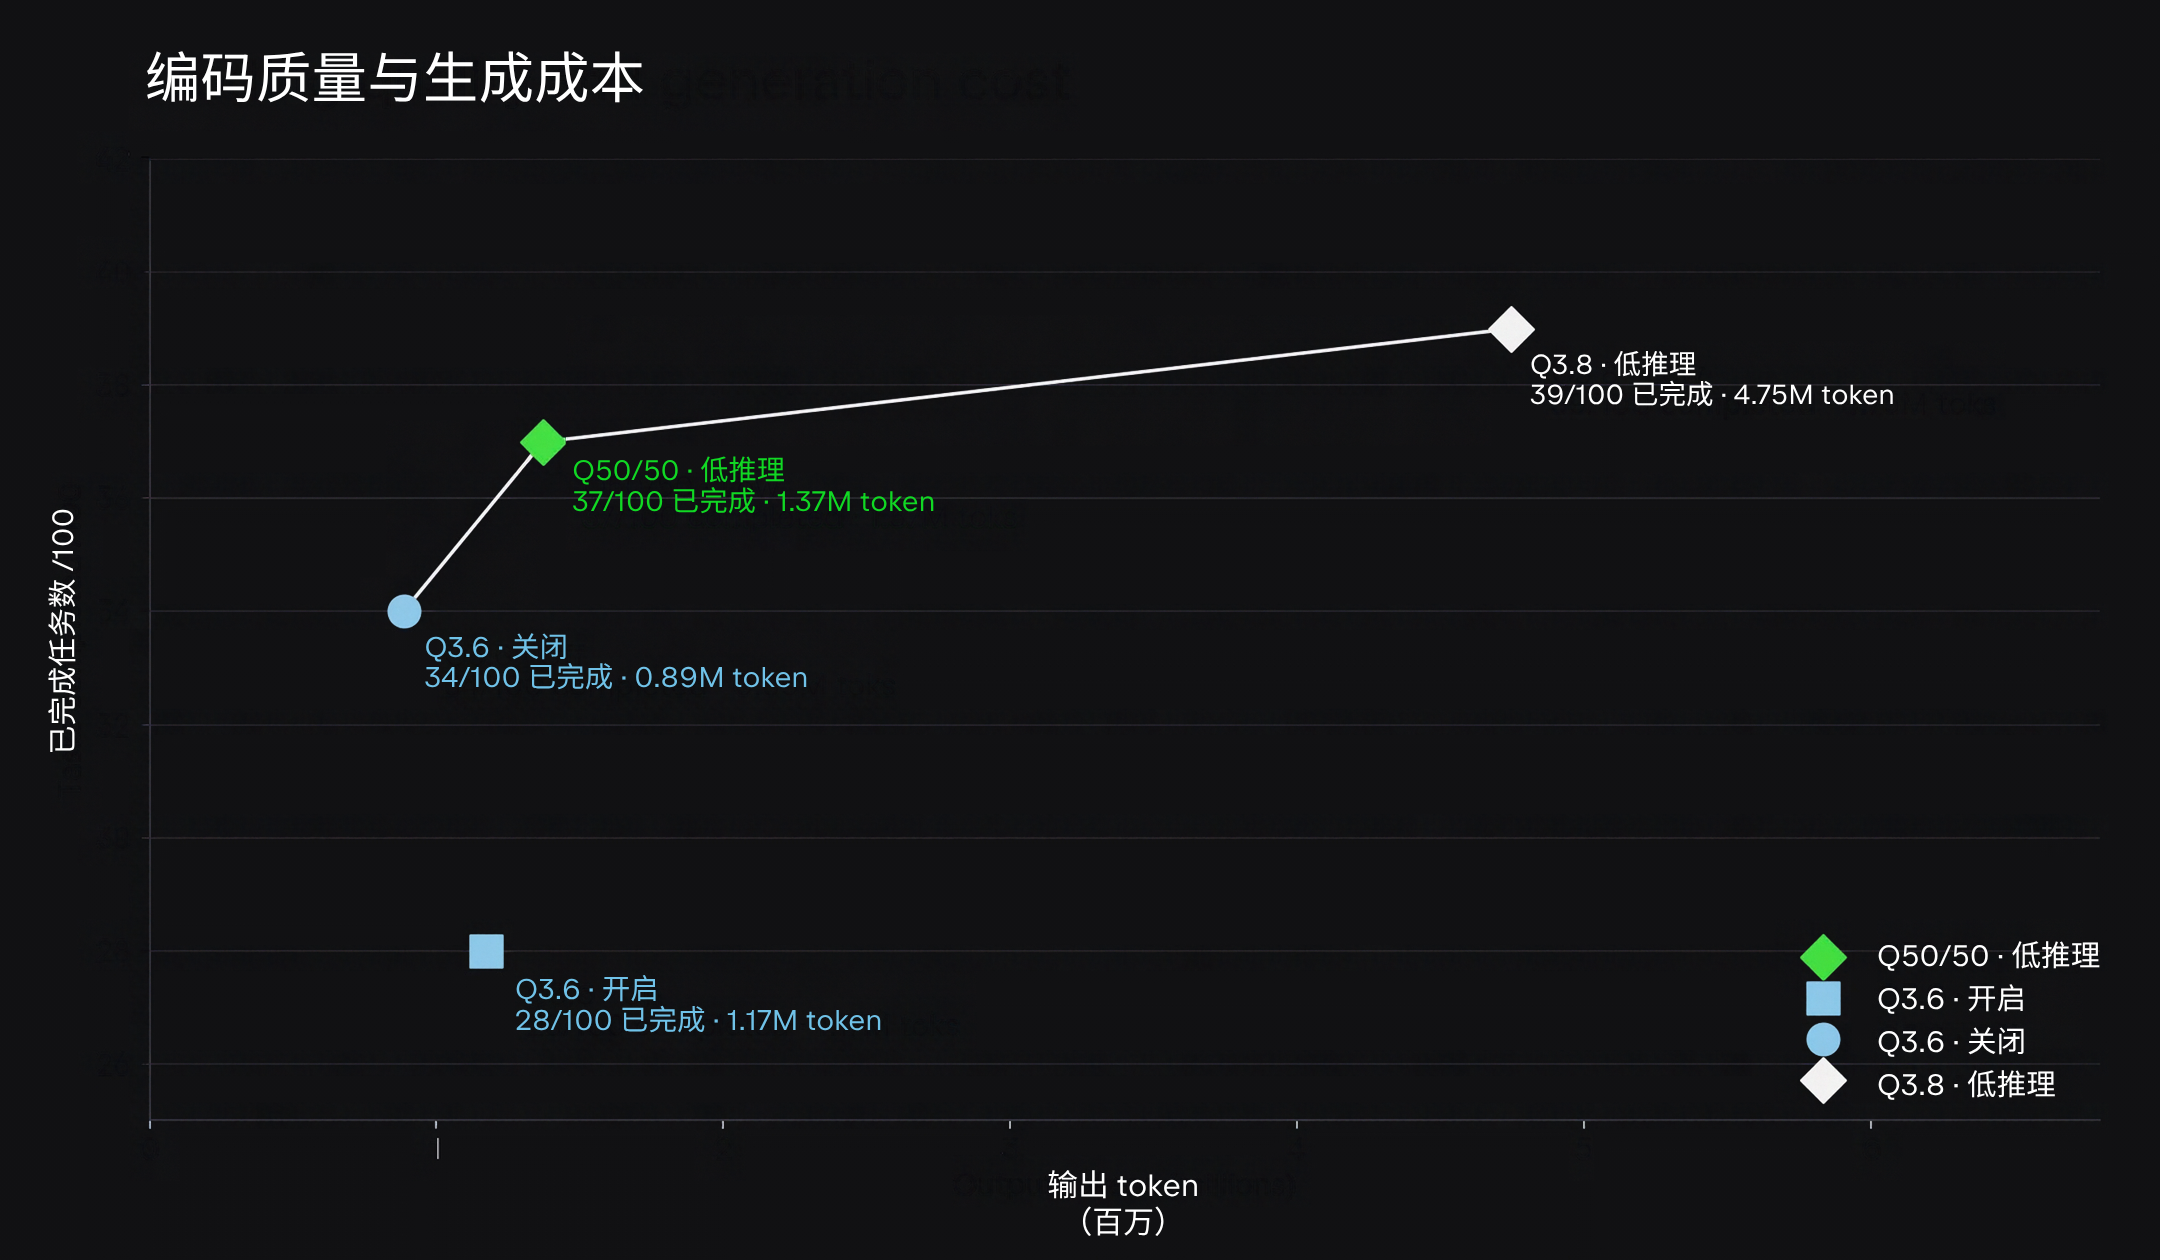
此次更新旨在消除这一取舍。我们将两个模型按相同比例合并,构建了 Qwen3.8-3.6-27B-blend。在编码评测中,它完成的任务多于 Qwen3.6,同时生成的输出 token 比 Qwen3.8 少 71%。
本文将介绍新模型如何改进编码结果、我们如何让它高效运行,以及测试过程中得到的经验。我们也通过 Windows 上的实验性 NVIDIA 支持,让 Junie Local 可以在更多机器上运行。
更聪明、思考更少的模型
在我们包含 100 个任务的内部编码基准测试中,新模型完成了 37 个任务,而关闭推理的 Qwen3.6 完成了 34 个。它的成绩接近 Qwen3.8 的 39 个,同时生成的输出 token 少了 71%。
真的节省 token 了吗?
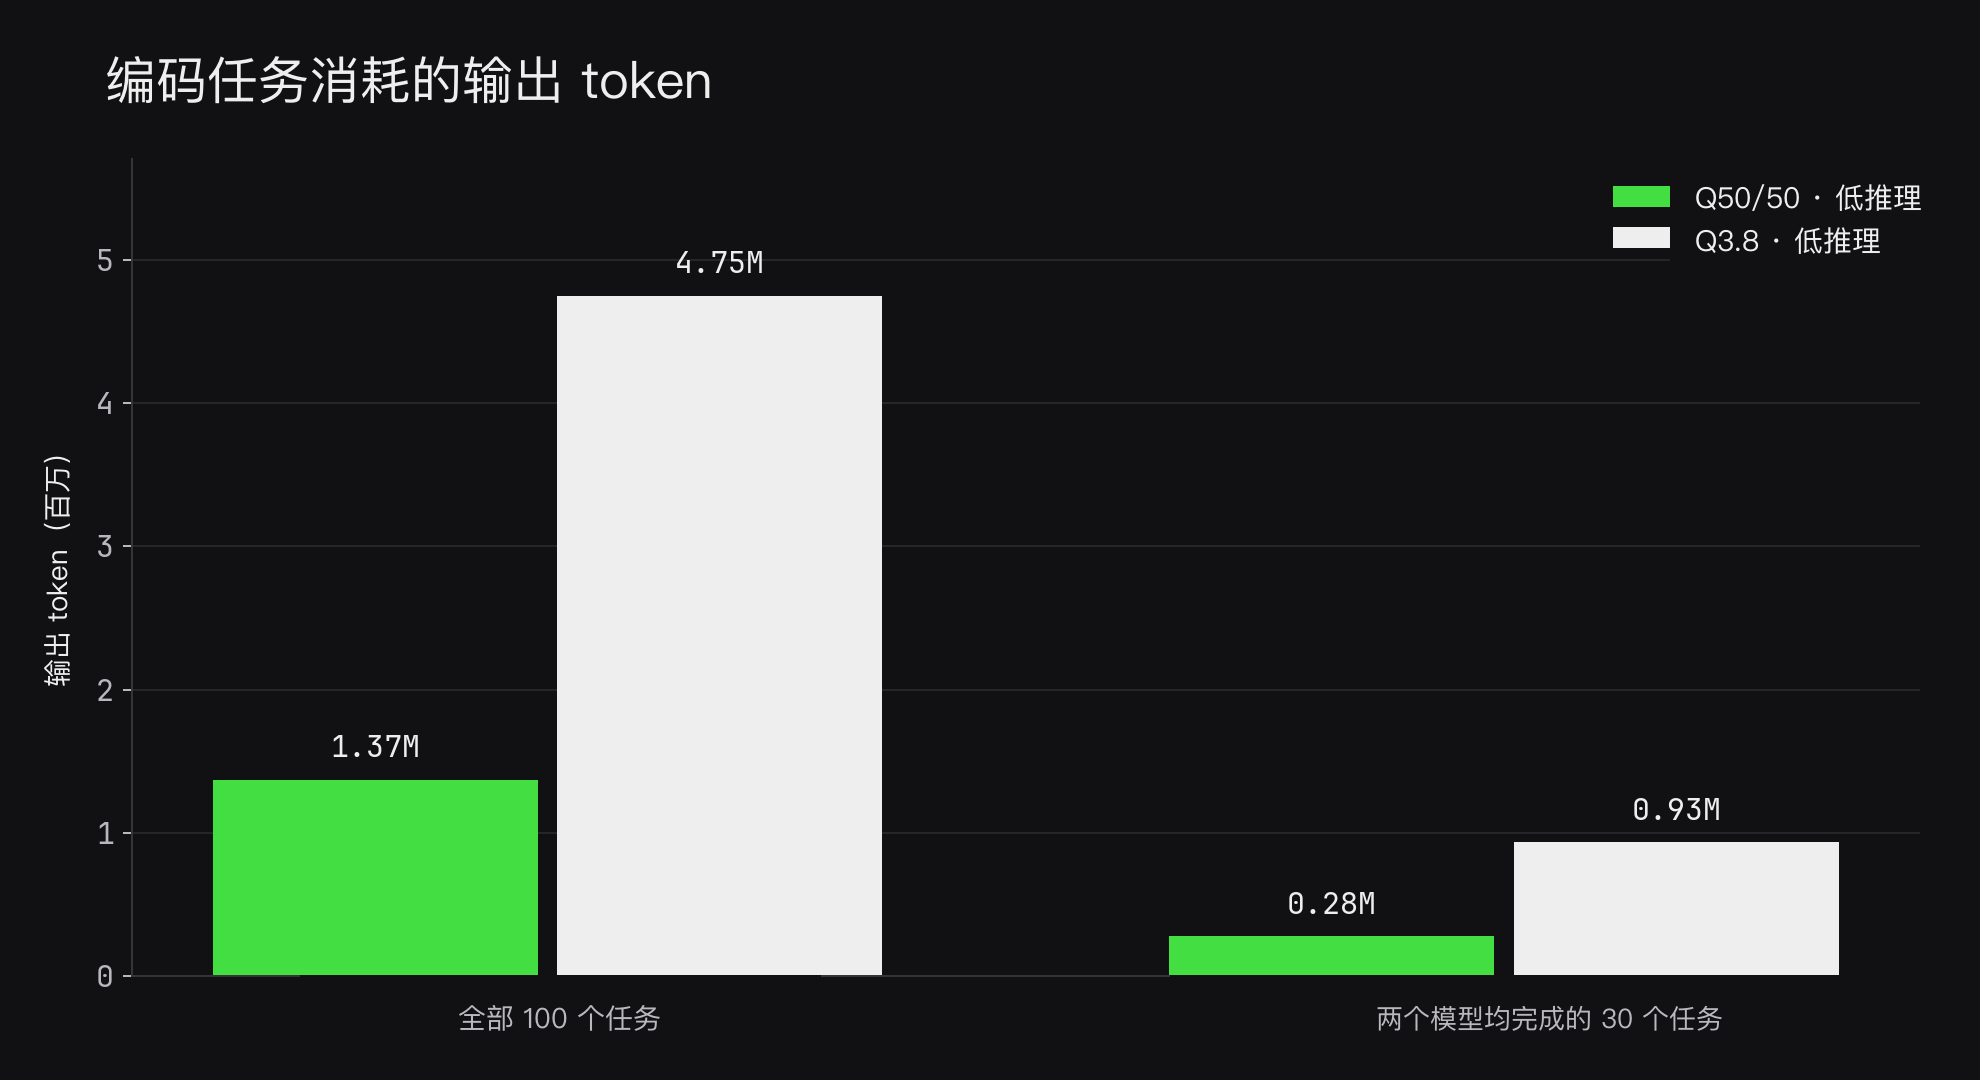
一种可能的解释是:混合模型只是在卡住时花费的 token 更少。为验证这一假设,我们比较了 Qwen3.8 和混合模型都完成的 30 个任务。在这些任务中,混合模型生成的 token 约少 70%——混合模型为 279K,Qwen3.8 为 935K。在这 30 个任务中,有 29 个任务都是混合模型使用的 token 更少,这进一步证明了它的 token 效率。
值得测试的简单合并
我们从一个简单的实验开始。Qwen3.8-27B 基于 Qwen3.6-27B,二者采用相同的架构,因此我们直接按相同比例合并了它们的权重。这样无需任何额外的后训练,就能得到一个 27B 模型。
不过,这种简单的混合已经带来了出人意料的实用改进。早期结果好于预期,因此我们开始在更多基准测试和任务上评估这个模型。这些评测给了我们足够的信心:在其他实验继续进行的同时,将它作为此次发布使用的模型。
减少推理时间有很多方法,包括蒸馏、强化学习以及更复杂的模型合并方法。我们仍在进行更广泛的模型和运行时实验,相关成果将在未来的 Junie Local 版本中陆续呈现。
多个基准测试,多次运行
为了了解新模型在智能体编码任务之外的表现,我们还使用了多个公开基准进行评测。重复运行评测可以帮助我们判断哪些任务能够稳定完成、不同运行之间的差异有多大,以及某项结果是否依赖一次恰好有利的采样。
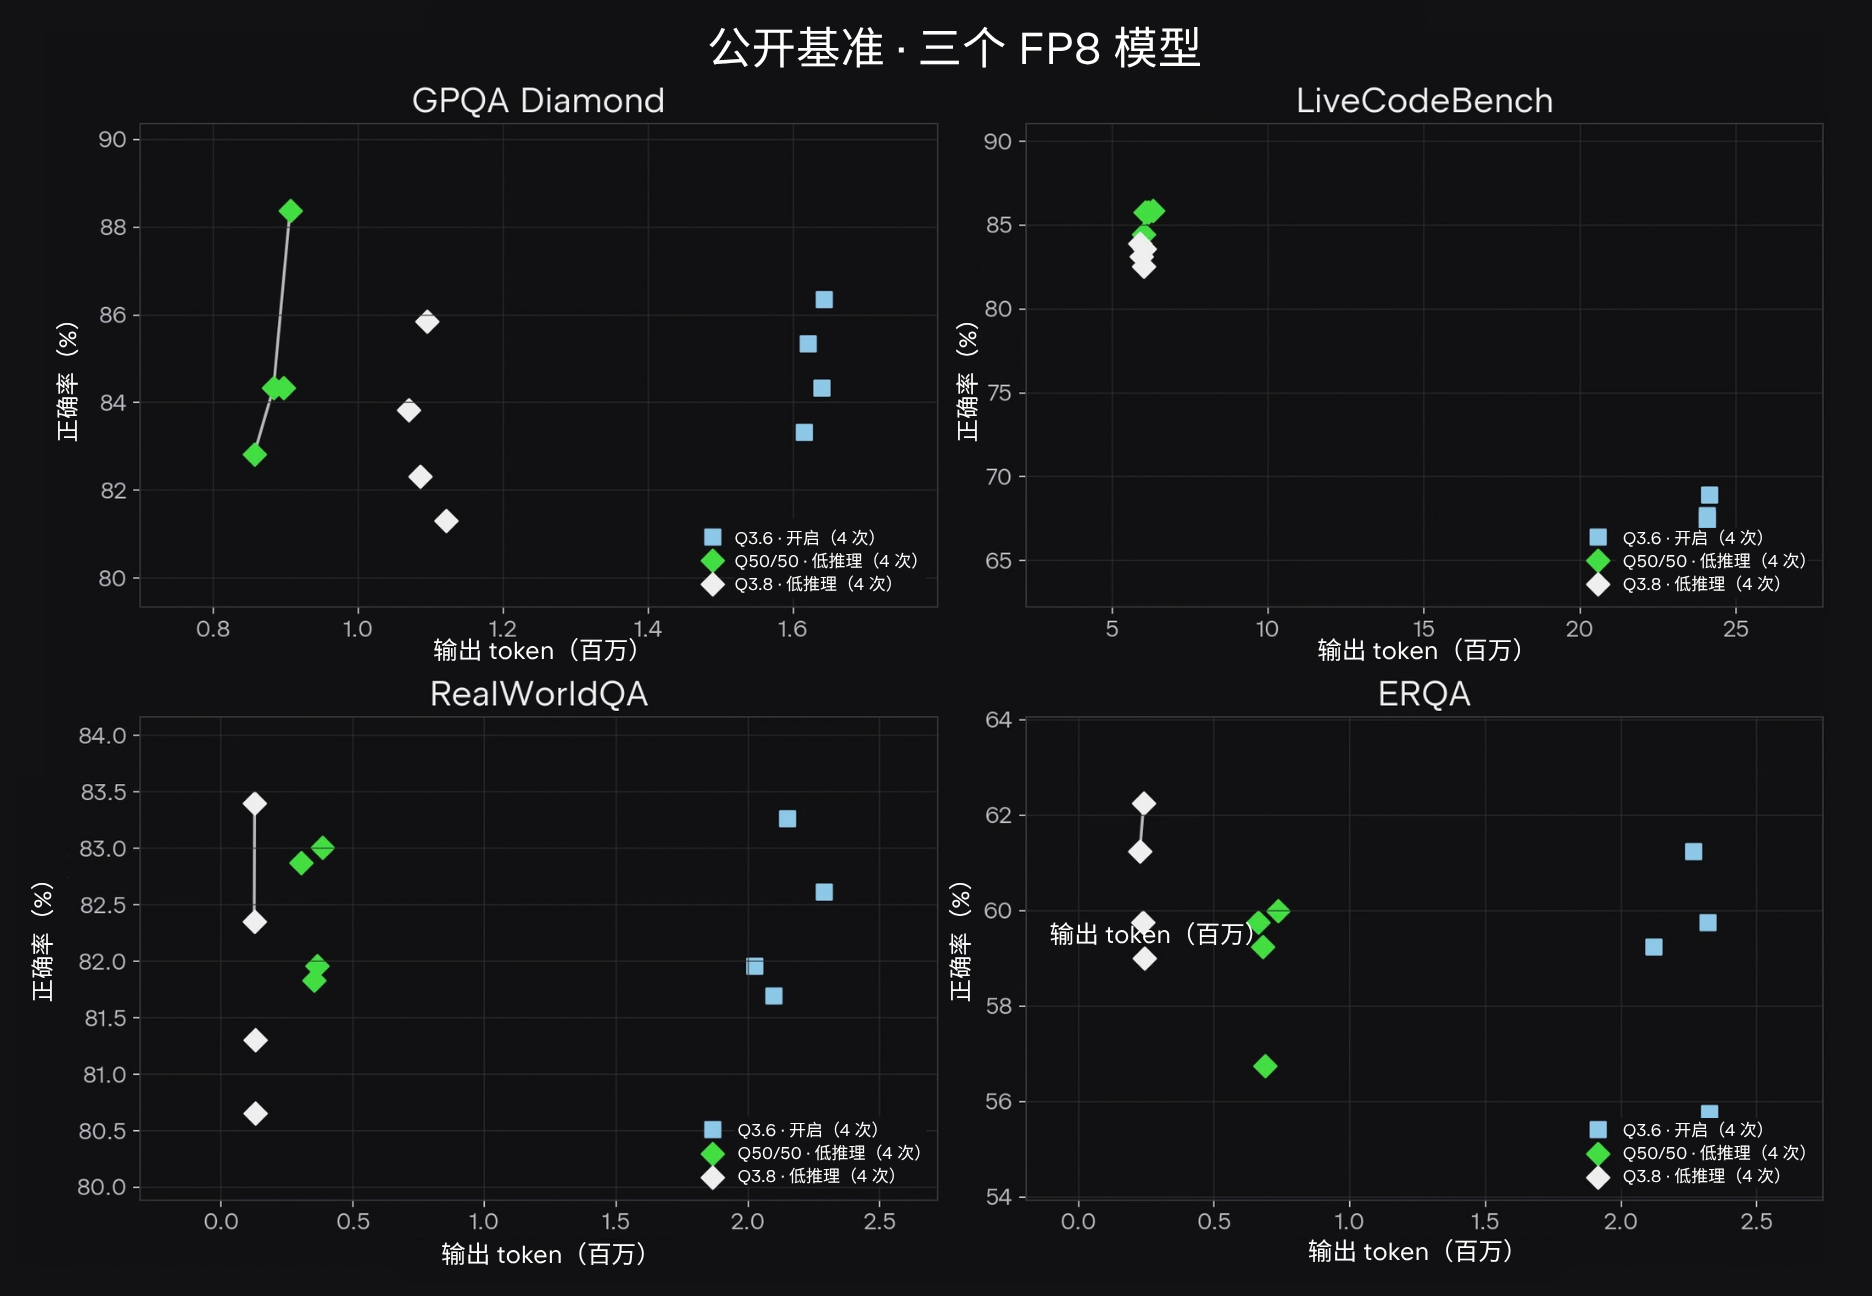
在四次 LiveCodeBench 运行中,混合模型的平均正确率为 85.47%,Qwen3.8 为 83.29%,二者的输出成本相近。Qwen3.6 的四次完整运行平均正确率为 67.87%,每次运行约使用 2410 万个输出 token;混合模型则约为 614 万个。
视觉基准测试呈现出另一种取舍。混合模型使用的 token 明显少于启用思考的 Qwen3.6,但多于 Qwen3.8。我们核对了相同的问题、图像和生成设置,发现多出的 token 几乎全部来自混合模型花费了更多时间进行推理。
后续工作
混合模型在难以找到解决方案时仍可能过度思考。如果 Junie 在没有新证据或有效工具结果的情况下反复尝试同一种方法,我们建议中断任务,并用更聚焦的目标重新开始。
成功推理的效率也还有提升空间。在四次完全相同的基准测试运行中,思维链(CoT)的长度差异很大。如果选择较短的正确推理轨迹,token 使用量可以减少 24.5%。这表明更短的成功路径确实存在,我们或许可以教会模型选择这些路径,并且不损失任何性能。
让模型高效运行
模型决定 Junie 生成多少文本,运行时则决定这些文本多快呈现给你,以及需要占用多少内存。我们的目标是同时改进这两个方面。
关于推测解码的思考
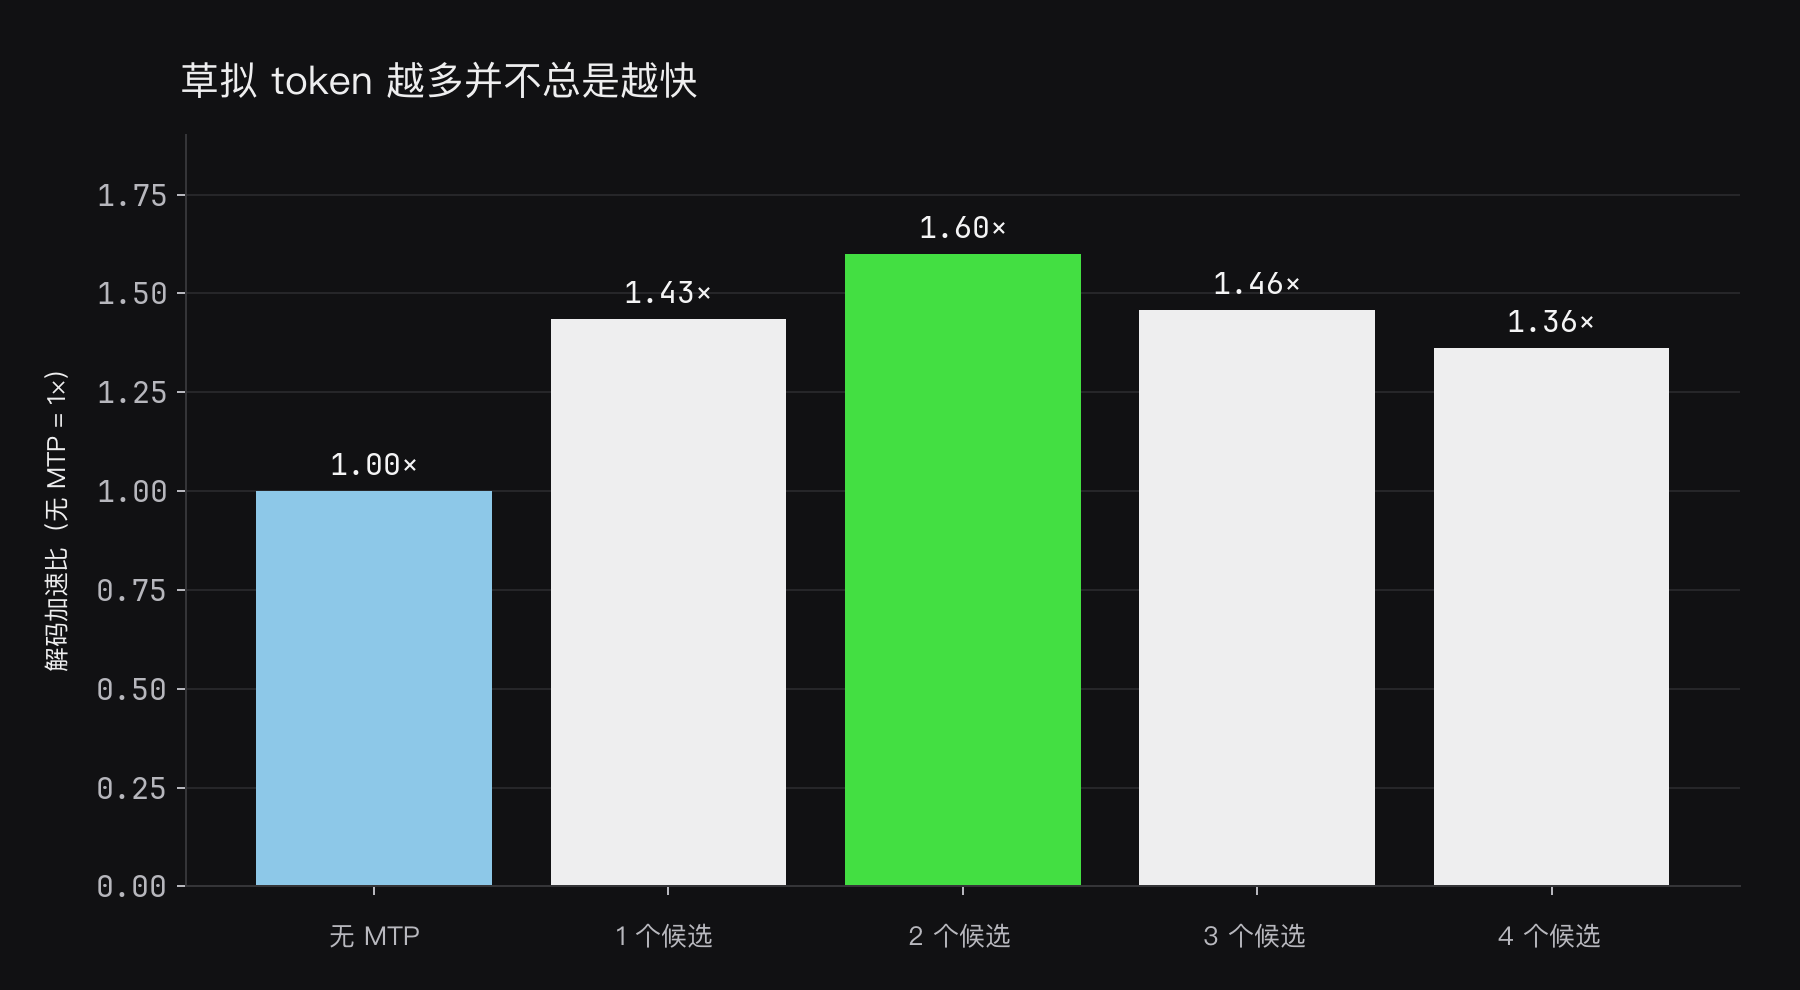
Junie Local 已经使用多 token 预测(MTP)。一个名为 MTP head 的小型子网络会提出多个 token,由主模型并行检查。提议正确时,每一轮就能输出更多 token。我们希望提出更多正确的候选,但这也会增加 GPU 的工作量,因此并不一定能加快生成速度。
MTP 每轮应该提出多少个 token?
在 M5 MacBook Pro 上,每轮提出两个 token 时,解码速度比不使用 MTP 快 60%。增加到四个后,加速幅度反而降至 36%,因为生成并检查候选所需的额外 GPU 工作量,超过了接受更多 token 带来的收益。
MTP 的准确率重要吗?
我们比较了四位 MTP head(Q4)与八位 MTP head(Q8)在真实编码轨迹中的表现,覆盖从 16K 到 128K 的五种上下文长度,每种长度使用三个随机种子。Q4 接受了 63.0% 的候选,Q8 则接受了 63.6%:
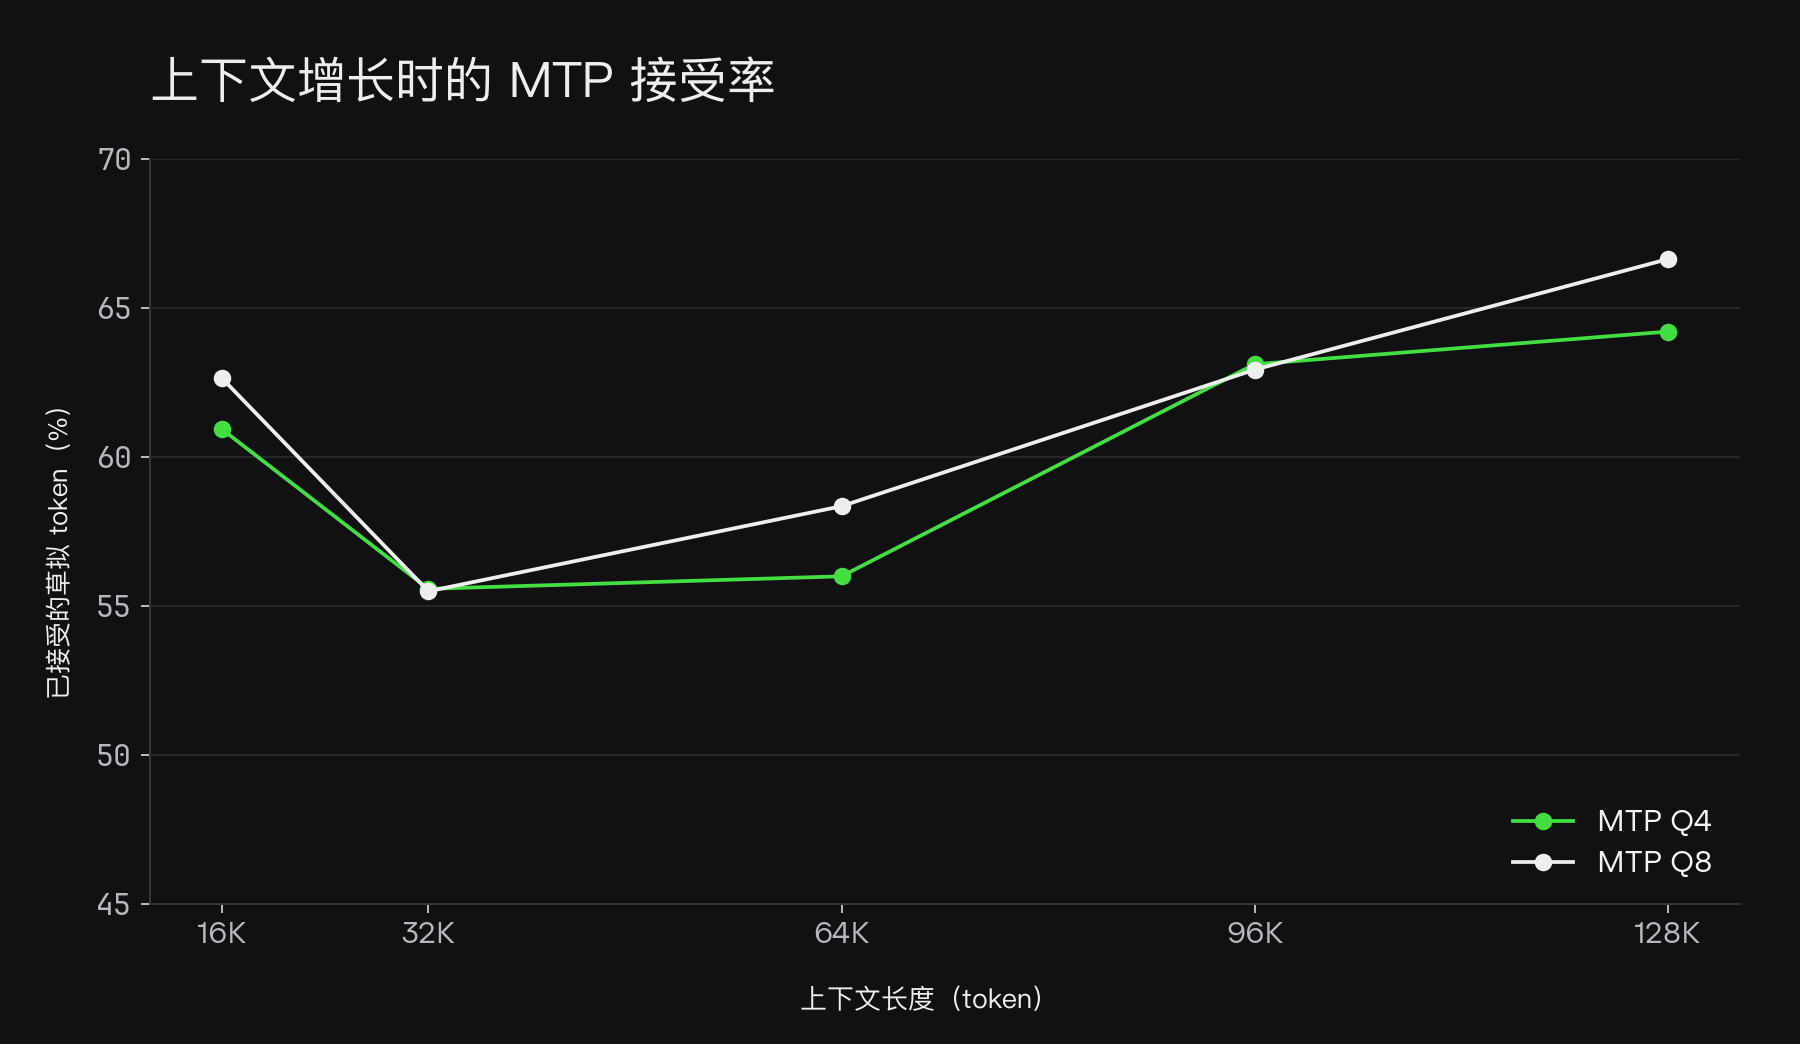
接受率说明候选有多常发挥作用,而解码速度则说明它们是否真正节省了时间。
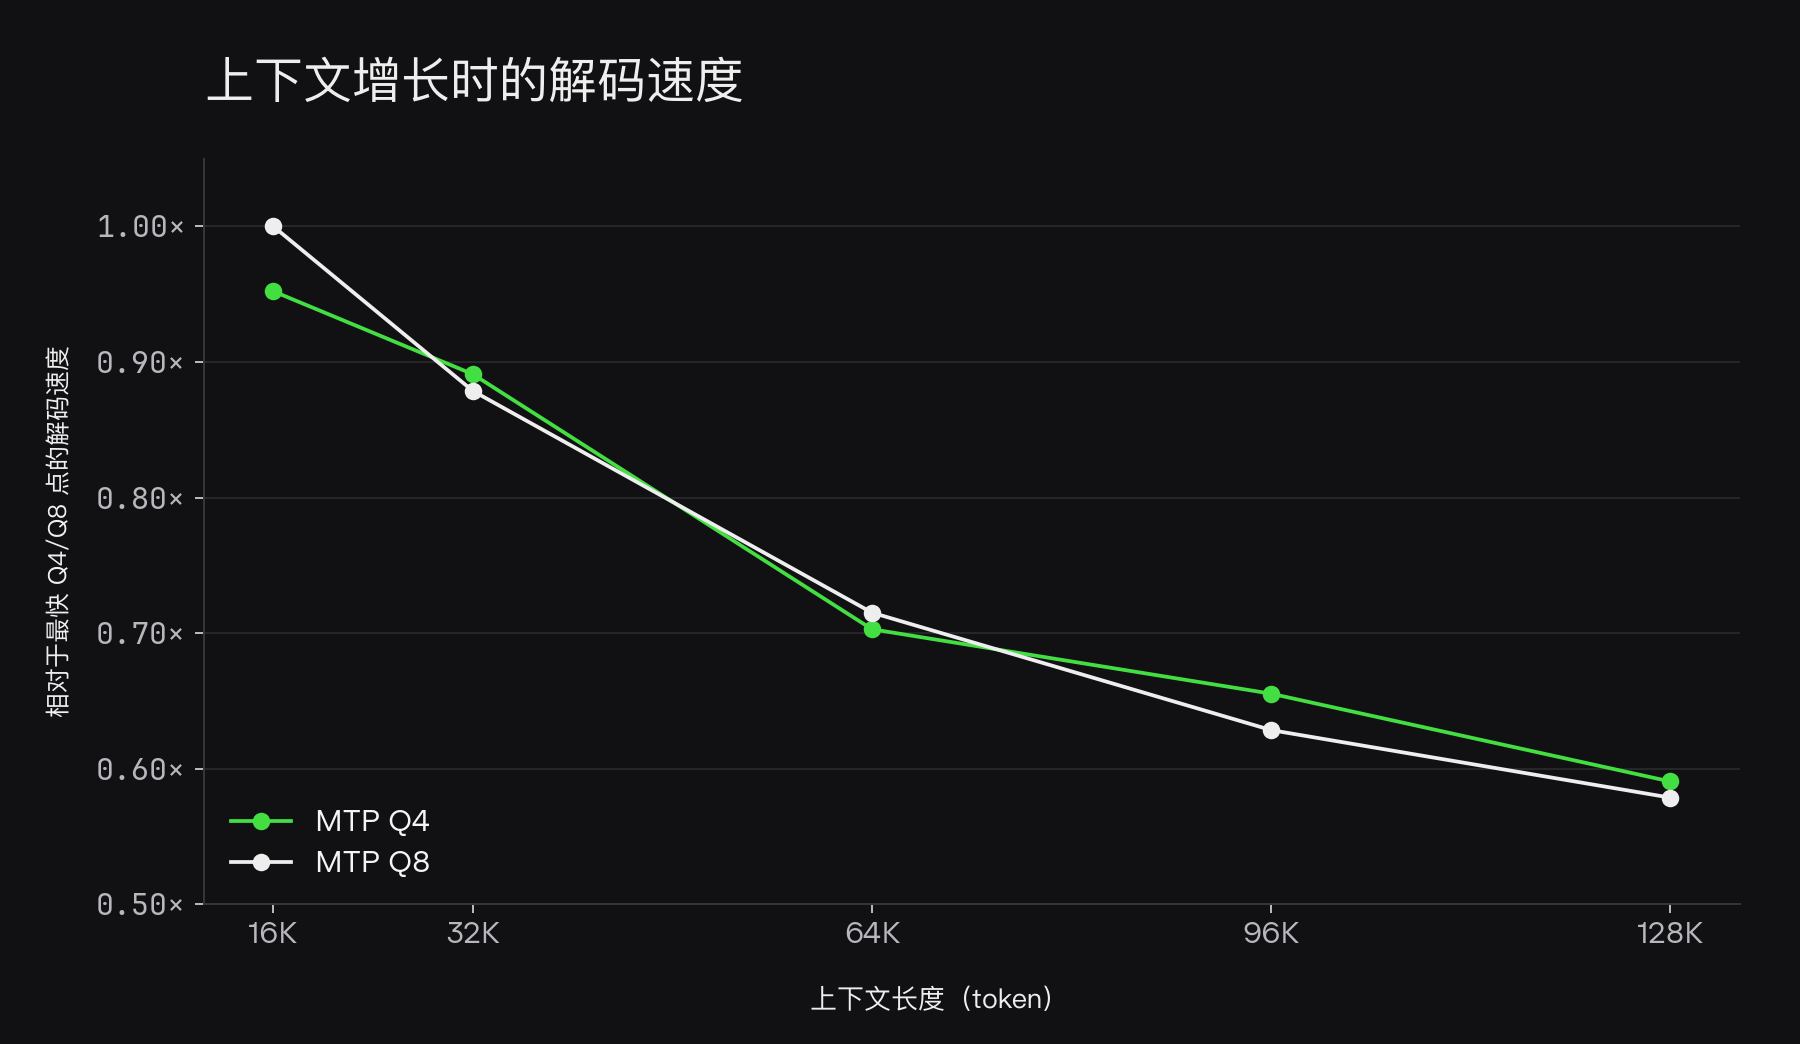
我们没有发现 Q8 MTP head 具有稳定的速度优势,因此保留了 Q4,以节省内存。
为了了解 MTP 为什么会随上下文变长而减速,我们分析了 token 验证过程中的 GPU 负载。注意力计算占据了大部分增量:每轮耗时从 8.4 毫秒上升到 40.2 毫秒,而前馈计算和 Gated DeltaNet 计算的耗时几乎保持不变。
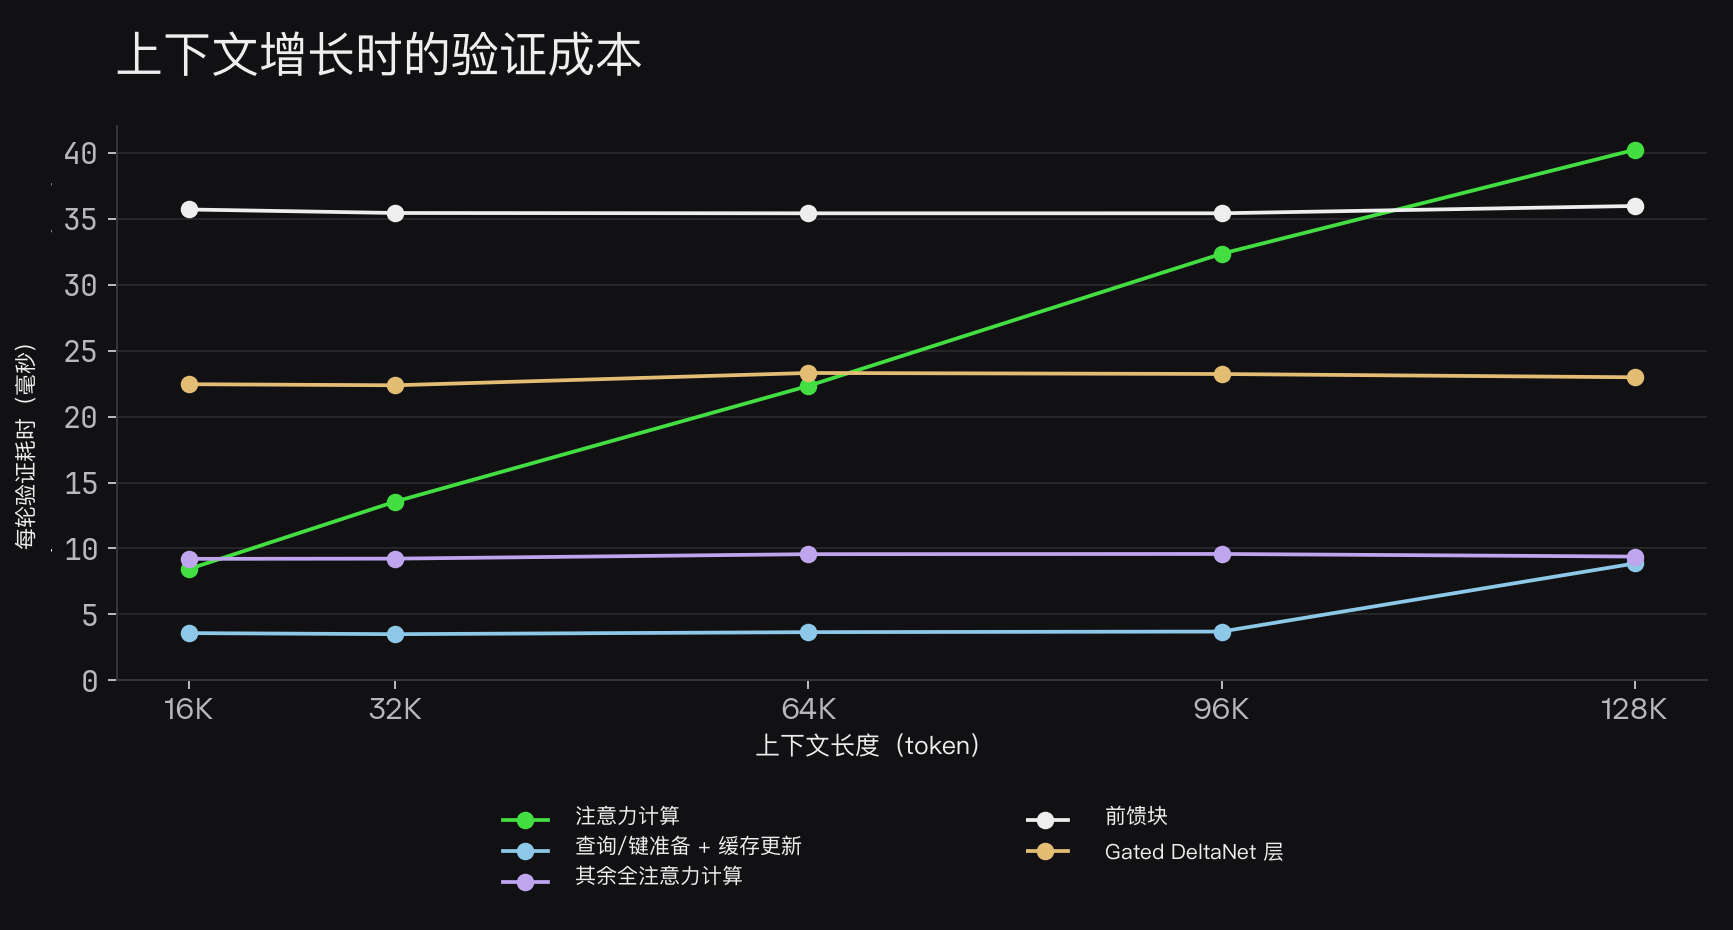
由于 MTP 存在这一限制,即使预测仍然准确,随着 Junie 进行较长的编码会话,响应速度也会逐渐下降。我们正在研究如何降低验证成本,让 Junie 在会话持续进行时仍能保持响应迅速。
一个隐蔽的症结
在早期开发阶段,我们的内部评测出现了性能下降,但在实际使用 Junie Local 时却无法复现。原因在于我们为保证评测可复现而引入的一项设置:每个请求都使用相同的随机种子。这会造成数值不稳定,因为复用随机种子会让相同的 token 在采样器每次生成 token 时获得相同的随机优势。当模型的预测保持相似时,即使提示词发生了变化,它仍可能被重新引向失败的操作。值得注意的是,Qwen3.8 受这种不稳定性的影响比我们测试的其他模型更大。
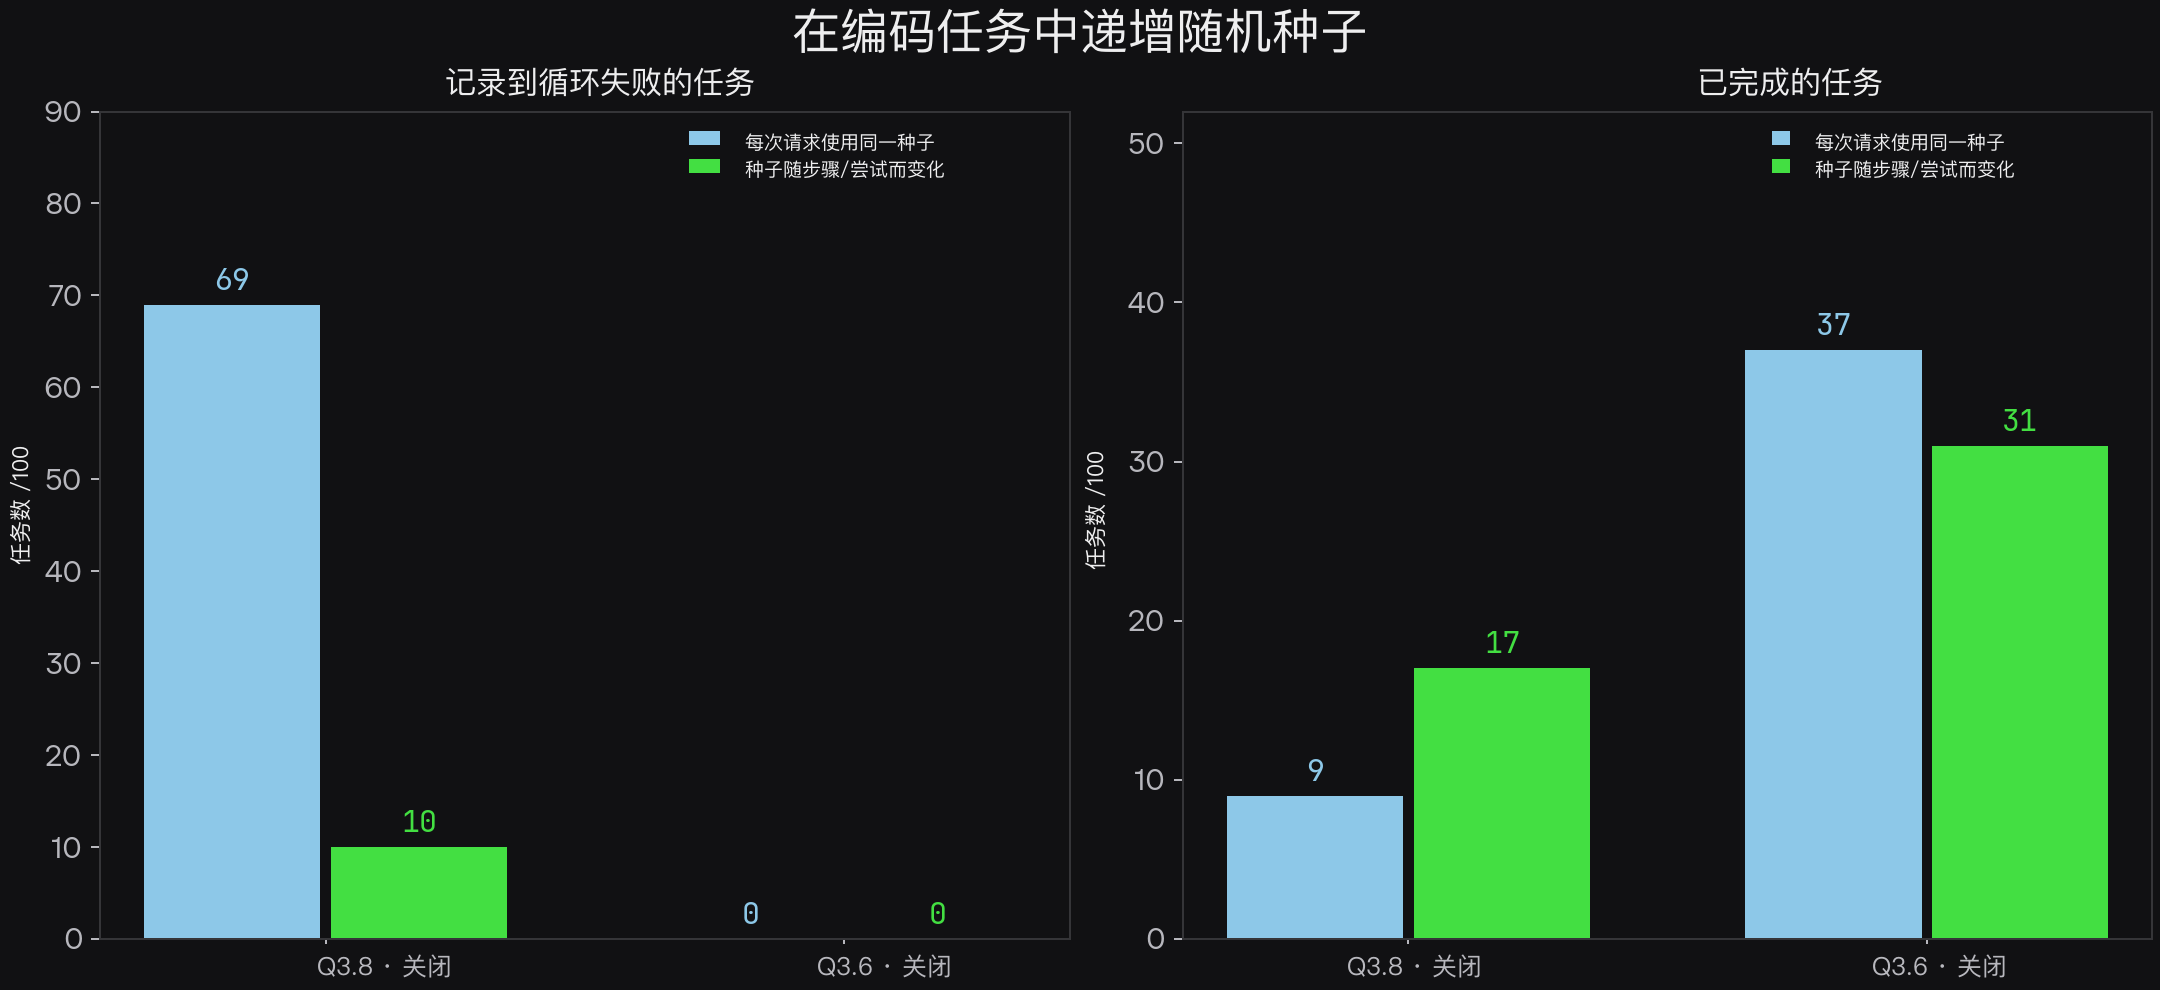
我们修正了评测设置:在智能体的每个步骤和每次反思尝试中递增随机种子。这样既能保持测试可复现,也能让后续尝试选择不同的路径。
体验升级
Apple M5 用户现在已经可以通过 Junie 试用新模型:
junie
运行 /local 并安装 Qwen3.8-3.6-27B-blend,即可将 Junie Local 切换到新模型。请确保 Junie 已更新至最新版本。
对于 Windows 用户,Junie 的 nightly build 现已包含实验性 RTX 支持,覆盖所有基于 Ampere 或更新架构、且显存至少为 24 GB 的 NVIDIA RTX 显卡。
junie --channel=nightly
这一早期预览版本让你可以在 Windows 上试用 Junie Local,并通过反馈帮助我们推动后续开发。
你可以在 Hugging Face 上找到 Qwen3.8-3.6-27B-blend。
Qwen3.8-3.6-27B-blend 只是我们更广泛的模型与运行时研究所取得的一项成果。我们会继续推进这项工作,并在未来的 Junie Local 版本中带来更多成果。
本博文英文原作者:Vladimir Sotnikov。
本文由 AI 辅助翻译,并经人工审校。如发现任何问题,欢迎在评论区留言指正。